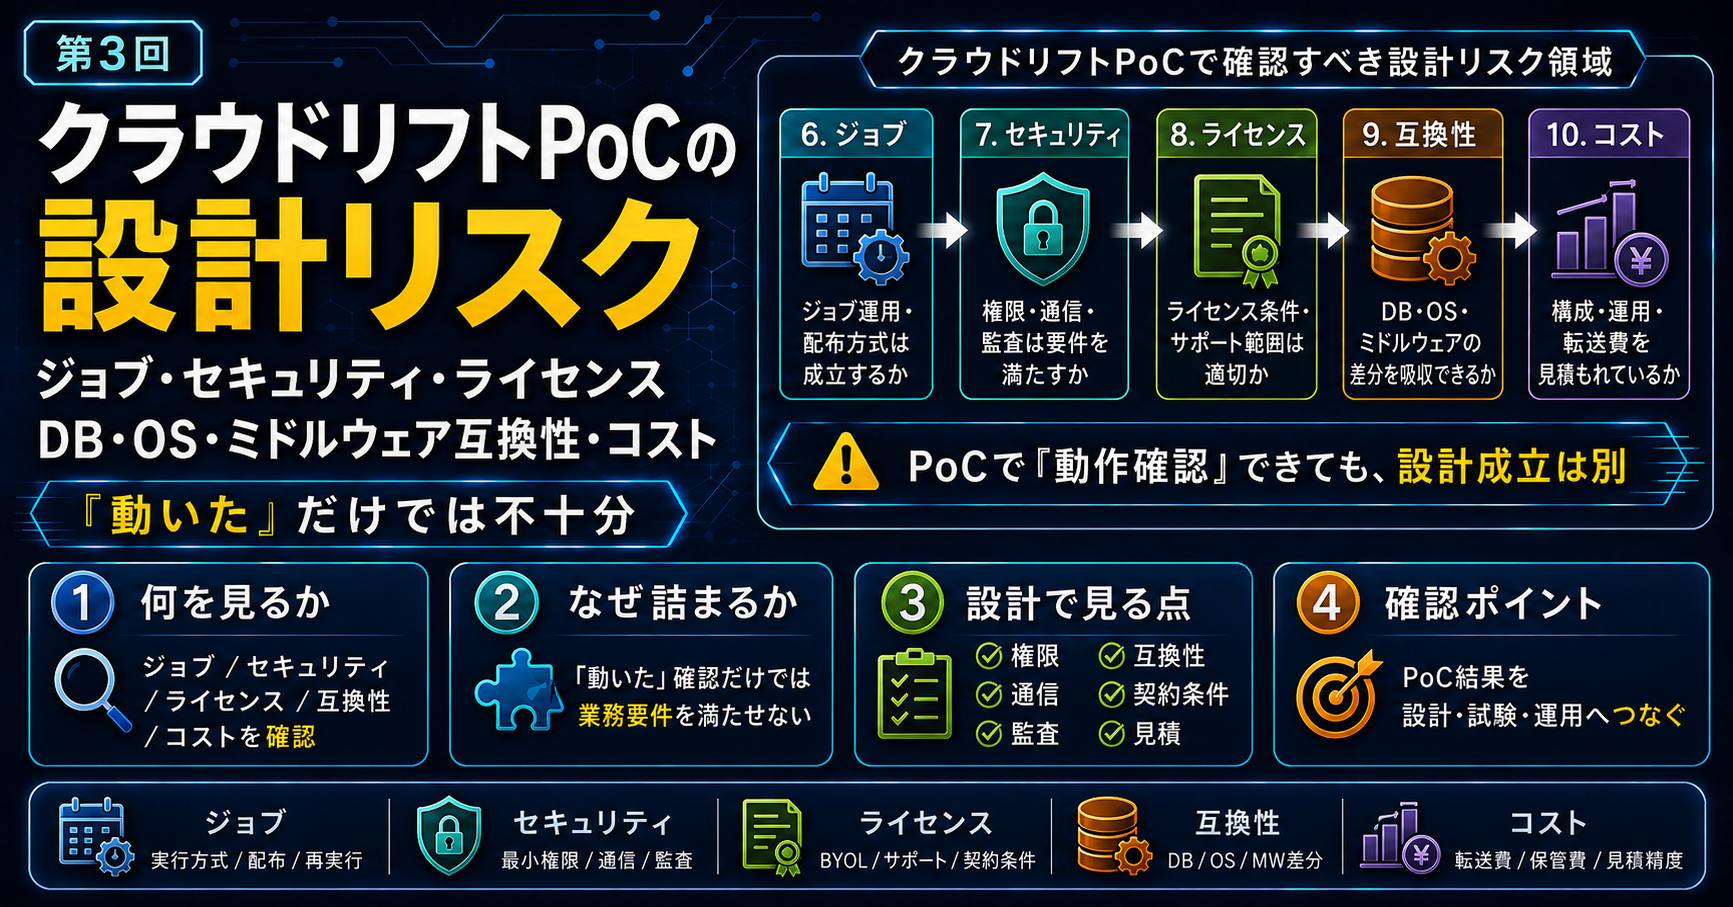
この記事は「クラウドリフトPoCで設計リスクを潰す」全3回シリーズの第3回です。
本シリーズでは、クラウドリフトのトラブルを個別の設定ミスとしてではなく、構築前に残った設計リスクという観点から整理します。
- 【第1回】クラウドリフトの失敗は構築前に始まっている|PoC不足が手戻りを招く理由
PoC不足が、なぜ構築・試験・運用での手戻りにつながるのか - 【第2回】クラウドリフトPoCの設計リスク|可用性・性能・ストレージ・バックアップ・監視
可用性/性能/ストレージ/バックアップ/監視の5領域 - 【第3回】この記事
クラウドリフトPoCの設計リスク|ジョブ・セキュリティ・ライセンス・DB互換性・コスト
※この記事は途中まで無料でお読みいただけます。続きはnote(有料)で公開しています。
はじめに
「IAMロールを設定して、必要なAWSリソースへアクセスできた」
「RDSに接続でき、既存アプリも動いた」
PoCでは、こうした動作確認を行います。
もちろん必要な確認です。
ただし、技術的に動くことと、その方式で運用・保守・統制・コスト管理まで成立することは別です。
例えば、ジョブを実行できても、異常終了後の再実行や依存関係まで設計できているとは限りません。
IAMでアクセスできても、最小権限、本番作業時の一時権限、監査証跡まで成立しているとは限りません。
製品をAWS上で動かせても、ライセンス条件やベンダーサポートの対象になるとは限りません。
RDSや別のOSへ移行できても、オンプレミスで使っていたDB運用やスクリプトをそのまま継続できるとは限りません。
また、初期見積が安く見えても、データ転送、バックアップ、ログ保管、スケール後のリソース量まで含めると、想定したコストにならないことがあります。
第3回では、こうした「動いた後」に問題になりやすい5領域を扱います。
- ジョブ管理・アプリ配布
- セキュリティ・アクセス管理
- ライセンス・製品サポート
- DB・OS・ミドルウェア互換性
- コスト・キャパシティ管理
これらに共通するのは、AWSサービス単体の動作確認だけでは判断できないことです。
既存業務の処理方式、運用ルール、権限管理、製品条件、DB・OSの制約、コストモデルと、AWS上の構成をつなげて確認する必要があります。
PoCで見るべきなのは、「使えるか」だけではなく、「その方式で運用まで成立するか」です。
ここからは、ジョブ・セキュリティ・ライセンス・DB/OS/ミドルウェア互換性・コストの5領域について、PoCで確認すべき点と、見落とした場合の後工程への影響を整理します。
PoC観点を強化するきっかけになった個別事例
以下は、クラウドリフトPoCの観点を見直すきっかけになった個別事例です。
本記事では、これらの個別事例に加え、PoCで事前に潰すべき設計論点も含めて、クラウドリフトPoCで見るべきリスクを整理しています。
個別事象そのものを詳しく扱うのではなく、そこからどのようなPoC観点を抽出すべきかに焦点を当てています。
- 【AWS】別AZで起動したWindowsが通信不能に|原因はVPCではなく「OS内のルート情報」だった
- CloudWatch Logsのログエクスポートが失敗した話|「ジョブは動く」と「運用で回る」は別物
- バックアップ設定の「5日保存」は、5営業日分とは限らない|AWS Backupの保持期間から考える、詳細設計の落とし穴
- EBSは増やせても、簡単には減らせない|RHEL環境で見落とした「容量縮小=ディスク移行」という現実
- S3バケットにあるのに取得できない|クロスアカウント構成で見落とした「オブジェクト所有者」の罠
- RHELで使えた設定方法が、Amazon Linuxでは使えなかった|MTU設定に見る、OS差分と永続化確認の落とし穴
- EBSは見えているのにマウントできない?|AMIコピーで起きた落とし穴
- AMIからRHELインスタンスを起動したらSSHログインできなくなった|cloud-initが上書きする設定を知らないと、復旧以前に入れなくなる
- EC2を止めただけなのに再作成?Auto Scaling運用の落とし穴|クラウドの自動化は、作業者の意図までは読んでくれない
なお、後編では購入者特典として、10項目全体を整理したExcel資料「クラウドリフトPoC設計リスクチェックリスト」も添付します。
PoC計画、設計レビュー、リスク洗い出しのたたき台として使えるようにしています。
ジョブ管理・アプリ配布
Lambdaで起動できることと、ジョブ管理を置き換えられることは違う
クラウドリフトでは、ジョブ管理が軽く見られることがあります。
- EventBridgeでスケジュール実行できる。
- Lambdaで処理を起動できる。
- Step Functionsで処理の流れを組める。
- Systems Managerでコマンドを実行できる。
- ECSやBatchでコンテナ処理を流せる。
確かに、クラウド上で処理を起動する手段は多くあります。
しかし、既存システムのジョブ管理は、単なる定時実行ではないことがあります。
たとえば、JP1/AJS3のようなジョブ管理製品を使っている環境では、ジョブネット、先行後続関係、異常時停止、再実行、保留、手動起動、カレンダー、休日、締め日、排他制御、通知、実行証跡、運用手順が一体になっていることがあります。
ここでJP1/AJS3を挙げているのは、特定製品の使い方を説明したいからではありません。
既存の業務ジョブでは、ジョブ管理製品が単なるスケジューラではなく、業務運用そのものを支えていることがある、という話です。
- 日次処理が終わったら、後続の集計処理を流す。
- 月末だけ別の処理を追加する。
- 締め日が休日なら前営業日にずらす。
- 異常終了したら、特定のリカバリポイントから再実行する。
- 二重起動を防ぐ。
- 一部の処理だけ保留し、運用判断後に再開する。
- 失敗時には監視へ通知し、運用手順書に沿って復旧する。
こうした制御まで含めて、業務ジョブは成立しています。
そのため、PoCで見るべきなのは、「AWS上で処理を起動できるか」ではありません。
既存ジョブネットの依存関係、異常時の止まり方、再実行単位、通知、証跡、運用手順まで含めて、クラウド上でも業務として回せるかです。
リトライと再実行は同じではない
クラウドサービスでは、失敗時のリトライを簡単に設定できることがあります。
しかし、リトライと業務上の再実行は同じではありません。
一時的な通信エラーで、同じ処理をもう一度実行すればよい場合もあります。
一方で、途中までデータを更新した後に失敗した場合、単純にリトライすると、二重更新、二重送信、二重集計になることがあります。
たとえば、
- ファイルを取り込んだ後にDB更新で失敗した場合。
- DB更新後に帳票出力で失敗した場合。
- 外部システムへ送信した後にステータス更新で失敗した場合。
- 前半の処理で一時ファイルを作成し、後半の処理でそれを後続システムへ渡す場合。
このような処理では、どこまで完了しているのかを確認し、どの地点から再開するのかを決める必要があります。
ジョブ管理製品では、ジョブ単位、ジョブネット単位、ステップ単位で、再実行や保留の考え方が整理されていることがあります。
これをクラウド側のリトライ設定だけで置き換えると、業務データの整合性を壊す可能性があります。
PoCでは、異常終了を意図的に発生させ、どこで止まるのか、どこから再実行できるのか、二重起動や二重更新を防げるのかを確認する必要があります。
ここを確認しないまま「Lambdaで起動できた」「Step Functionsで流れを組めた」と判断すると、構築後のジョブ設計や運用設計で手戻りになります。
ジョブカレンダーは、単なる時刻指定ではない
ジョブ管理で見落としやすいのが、カレンダーです。
- 毎日2時に起動する。
- 毎週月曜に起動する。
- 毎月1日に起動する。
この程度であれば、クラウド側のスケジュール機能でも表現しやすいかもしれません。
しかし、業務システムのジョブは、単純な時刻指定だけで動いているとは限りません。
- 営業日だけ動かす。
- 休日なら前営業日に寄せる。
- 月末営業日に締め処理を動かす。
- 特定の祝日だけ別処理にする。
- 年末年始だけ停止する。
- 決算月だけ処理順序を変える。
こうした運用が、既存のジョブカレンダーや運用手順に組み込まれていることがあります。
クラウド側でスケジュール実行できることと、既存の業務カレンダーをそのまま表現できることは違います。
特に、月末、締め日、休日、営業日判定が絡む処理は、単純なcron式や固定スケジュールだけでは表現しきれないことがあります。
PoCでは、通常日の起動確認だけでなく、月末、休日、締め日、年末年始など、業務上意味のある日付条件でジョブが期待どおりに動くかを確認する必要があります。
ジョブ実行サーバーは、クラウド上で同じ名前とは限らない
前編の可用性・信頼性でも触れたAuto Scaling後の登録問題は、ジョブ管理にも直結します。
オンプレでは、ジョブ管理マネージャーとエージェントの関係が、固定されたホスト名やIPアドレスを前提に設計されていることがあります。
- ジョブ管理マネージャーは、特定のジョブを、特定のジョブ実行サーバーに投入する。
- そのジョブ実行サーバーには、エージェントが導入されている。
- ホスト名、IPアドレス、エージェント名、監視対象名が、長期間変わらない前提で運用されている。
オンプレでは、この前提が自然に成立していたかもしれません。
しかし、AWSでは、Auto Scalingや復旧方式によってEC2が入れ替わることがあります。
- AMIから新しいEC2を作る。
- User Dataやcloud-initで初期設定を流す。
- ホスト名を付与する。
- DNSに登録する。
- 監視エージェントを起動する。
- ジョブ管理エージェントを起動する。
ここで順序や登録内容がずれると、EC2は起動しているのに、ジョブ実行対象として正しく認識されないことがあります。
- ホスト名が期待どおりに戻っていない。
- DNS登録が更新されていない。
- ジョブ管理エージェントが古い名前で登録されている。
- 監視対象名とジョブ実行対象名がずれている。
- Auto Scalingで作られたEC2が、ジョブ投入先として登録されていない。
この状態では、サーバーは動いていても、業務ジョブは流せません。
クラウドでは、EC2が起動すれば終わりではありません。
ホスト名、DNS登録、監視対象、ジョブ実行対象、エージェント登録まで含めて、業務システムの構成要素として戻っているかを見る必要があります。
オンプレ側ジョブ管理とAWS側処理が混在する期間もある
クラウドリフトでは、すべてのジョブを一度にAWSネイティブへ置き換えられるとは限りません。
オンプレ側のジョブ管理製品から、AWS上のEC2やLambdaを起動する。
AWS側の処理完了を、オンプレ側の後続ジョブへ返す。
一部のバッチは既存ジョブ管理に残し、一部の処理だけStep FunctionsやEventBridgeへ寄せる。
このような混在期間が発生することがあります。
このとき問題になるのは、単なる通信ではありません。
- ジョブの完了をどう判定するのか。
- 異常終了コードをどう返すのか。
- タイムアウトをどちらで管理するのか。
- AWS側でリトライした結果を、オンプレ側ジョブ管理へどう伝えるのか。
- オンプレ側で再実行した場合、AWS側の処理が二重に動かないか。
- ネットワーク断や認証エラーを、業務異常として扱うのか、基盤異常として扱うのか。
こうした運用上の境界を決めないままPoCを終えると、後工程でジョブ設計と運用設計が止まります。
PoCでは、オンプレ側ジョブ管理とAWS側処理が混在する前提で、起動、完了判定、異常通知、再実行、タイムアウト、証跡を確認する必要があります。
アプリ配布もPoC対象になる
ジョブ管理と合わせて、アプリケーション配布も確認が必要です。
オンプレでは、配布専用ソフト、共有フォルダ、運用スクリプト、手順書を使って、アプリケーション資材、設定ファイル、バッチ、帳票定義、ジョブ定義を各サーバーへ配布していることがあります。
クラウド移行後に、これをどう扱うのかを決めなければなりません。
- AMIに含めるのか。
- 起動時にS3から取得するのか。
- User Dataやcloud-initで展開するのか。
- CodeDeployやSystems Managerを使うのか。
- 既存の配布ツールをそのまま使うのか。
- 一部でCI/CD基盤を使う場合は、CodePipeline、CodeBuild、GitHub Actionsなどとどう接続するのか。
- コンテナ化を伴う移行であれば、ECR上のイメージタグやデプロイ対象の世代をどう管理するのか。
- ジョブ定義や設定ファイルの世代管理をどこで行うのか。
特にAuto ScalingやEC2再作成を使う場合、あとから作られたEC2にも、正しい資材が反映される必要があります。
- 既存EC2には最新版が配布されている。
- しかし、新しく作られたEC2には古い資材しかない。
- 設定ファイルだけ世代が違う。
- バッチは新しいが、ジョブ定義が古い。
- ロールバックしたつもりでも、一部のEC2だけ前の状態に戻っていない。
このような状態になると、クラウド上ではサーバーが起動していても、業務処理としては正しく動きません。
アプリ配布は、単なるリリース作業ではありません。
クラウドリフトでは、復旧方式、Auto Scaling、ジョブ実行対象、監視対象、ロールバック手順とつながる設計論点です。
PoCでは、初回配布だけでなく、更新、切り戻し、EC2再作成後の自動反映、世代管理、差分確認まで見る必要があります。
PoCで見るべき観点
既存ジョブの踏襲と代替の整理
- 単純な定時実行なのか、ジョブネット、依存関係、異常時停止、再実行、保留まで必要なのか
- EventBridge、Lambda、Step Functions、Systems Manager、ECS、Batchで代替できる処理と、既存ジョブ管理製品に残す処理を切り分けているか
異常系・カレンダー運用の担保
- リトライと業務上の再実行を区別しているか
- 異常終了時に、どこで止まり、どこから再実行できるか
- 二重起動、二重更新、二重送信を防ぐ仕組みがあるか
- ジョブカレンダー、休日、月末、締め日、営業日判定をどう扱うか
動的環境・ハイブリッド運用の壁
- オンプレ側ジョブ管理とAWS側処理が混在する期間の起動、完了判定、異常通知、タイムアウトを整理しているか
- Auto ScalingやEC2再作成後に、ホスト名、DNS登録、監視対象、ジョブ実行対象、エージェント登録が正しく戻るか
リリースと資材統制
- アプリケーション資材、設定ファイル、バッチ、帳票定義、ジョブ定義をどの方式で配布するか
- 新規起動したEC2にも、最新の資材と設定が自動で反映されるか
- リリース失敗時に、どの単位でロールバックできるか
ジョブ管理やアプリ配布は、クラウド化で自動的に整理されるものではありません。
AWS上で処理を起動できることと、既存業務のジョブ運用を置き換えられることは違います。
ジョブの依存関係、異常時の再実行、カレンダー、実行対象、配布方式、ロールバックまで含めて確認して、初めてクラウドリフトPoCとして意味があります。
ここまで見たジョブ管理・アプリ配布は、運用方式の問題です。
ただし、クラウドリフトで後工程に効いてくる論点は、これだけではありません。
権限設計、クロスアカウントアクセス、ライセンス条件、DB・OS・ミドルウェアの互換性、そしてコスト管理も、PoC段階で見ておかないと設計後半で手戻りになります。
セキュリティ・アクセス管理
IAMロールでアクセスできることと、業務上安全に統制できることは違う
クラウドリフトでは、セキュリティ設計も後回しにされがちです。
- EC2からS3にアクセスできた。
- LambdaからRDSに接続できた。
- IAMロールを付けたら処理が動いた。
- 踏み台経由でサーバーにログインできた。
- KMSで暗号化したデータを復号できた。
こうした確認は必要です。
しかし、それだけでは、業務システムとして安全に運用できるとは言えません。
クラウドでは、権限を付ければ多くのことができます。
だからこそ、誰に、どの権限を、どの範囲で、どの期間だけ与えるのかを設計しなければなりません。
コメント