はじめに
オンライン処理のサイジングは、本番環境に必要なサーバーやクラウドインスタンスについて、CPU、メモリ、構成、台数を根拠をもって決定するための作業です。
機器やインスタンスタイプを選定するには、「この構成で、どの程度の業務量まで、要求されたレスポンスタイムを維持できるのか」を明らかにする必要があります。
想定ユーザー数だけを見ても、システムへ加わる負荷は判断できません。同じ1000人が利用するシステムでも、利用者の操作頻度、参照処理と更新処理の割合、1回の操作で実行されるSQL、対象となるデータ量によって、必要な処理能力は大きく変わります。
実機サイジングでは、業務規模、データ量、業務シナリオ、処理の構成比、ピーク時の負荷などを検証条件として定義し、実際の業務に近い負荷を与えてシステムの処理能力を測定します。その結果を、本番で想定するピーク業務量、将来の増加、障害時に維持すべき処理能力と照らし合わせ、本番環境に必要なリソースや台数を決定します。
つまり、実機サイジングは単に負荷をかけて性能を確認する試験ではありません。本番環境の機器構成やクラウドリソースを選定するための根拠を作るプロセスです。
サイジングが本番環境に必要なリソースやサーバー台数を決めるための根拠を作るのに対し、性能テストは、実運用を想定した負荷・テストデータ・環境条件で、システムが性能要件を満たすかを確認する工程です。 負荷モデルやテストデータの設計、測定結果の評価まで含めた性能テストの進め方については、次の記事で詳しく解説しています。
本記事では、オンライン処理を対象として、性能要件と検証条件の整理、負荷モデルの作成、性能測定、性能曲線の評価、性能限界の分析、必要台数の算定までを一連のプロセスとして解説します。
オンライン処理のサイジング全体像
サイジングでは、最初からCPUコア数やメモリ容量、サーバー台数を決めるわけではありません。まず、本番環境でどの程度の業務量を、どの応答性能で処理する必要があるのかを明らかにし、その条件を実機で測定できる負荷へ変換します。
測定によって、1台または1構成単位が処理できる業務量、性能要件を満たせる範囲、性能が悪化し始める地点、性能限界を把握します。その結果を本番の業務量と比較することで、必要なリソースやサーバー台数を算定できます。
サイジングによって最終的に決定する主な内容は、次のとおりです。
- 必要なCPU、メモリ、ストレージ、ネットワークなどのリソース
- サーバーやクラウドインスタンスの種類
- Web/APサーバーなどの必要台数
- 障害時に必要となる冗長構成
- 通常稼働時に確保する性能余力
- 将来の業務量増加に対する増設条件や拡張方法
このうち、業務量やデータ量の増加に対し、リソース追加やサーバー増設によって処理能力を拡張する構成や方法を検討することを、本記事では拡張性設計と呼びます。サイジングは、現在の性能要件を満たす構成を決めるだけでなく、この拡張性設計の根拠にもなります。
これらの項目を根拠なく決めることはできません。性能要件、検証規模、検証データ、業務シナリオ、負荷方式などを定義し、同じ条件で再現可能な性能測定を行う必要があります。
オンライン処理のサイジングは、次の流れで進めます。

図の前半では、本番で必要となる性能を整理し、それを検証可能な業務シナリオや負荷モデルへ落とし込みます。後半では、負荷を段階的に増加させながら処理能力を測定し、性能曲線とリソース使用状況から性能限界とボトルネックを確認します。
最後に、測定によって得られた安全な処理能力を、本番のピーク業務量、将来の増加率、障害時の条件と照らし合わせ、必要なリソースやサーバー台数、拡張方針を決定します。
以降では、このプロセスに沿って、各工程で何を整理し、何を測定し、どのように本番構成の選定根拠へつなげるのかを説明します。
1.性能要件を整理する
サイジングに必要な性能要件は、単に「画面を3秒以内に表示する」といったレスポンスタイムだけではありません。
オンライン処理では、業務量、利用特性、ピーク、データ量、将来増加率を含めて整理します。
以降では、架空のオンラインシステムを例として、次の性能要件を前提にサイジングを進めます。

この性能要件を、後続の工程で検証規模、業務シナリオ、負荷モデル、測定条件へ具体化していきます。
登録利用者数と同時利用者数を混同しない
オンラインシステムでは、登録されている利用者全員が同時に処理を実行するわけではありません。
次の三つは分けて考える必要があります。
-
システムへ登録されている利用者数
-
同時にログインしている利用者数
-
同時にサーバーへ処理を要求している利用者数
1000人がログインしていても、多くの利用者が画面を確認したり入力したりしている間は、サーバーへリクエストを送信していません。
性能測定ツールで動かす仮想ユーザーについても、単なるログイン数とは区別します。本記事では、負荷ツール上で業務シナリオを繰り返している仮想ユーザーを「同時稼働VUser」と表記します。
一方、始業直後のログイン、チケット予約開始時刻、締切直前の申請などでは、短時間に多数のリクエストが集中することがあります。
利用者数から機械的に同時処理数を決めるのではなく、アクセスログや業務ヒアリングを基に、実際の利用状況をモデル化する必要があります。
性能余力はプロジェクトごとに合意する
性能限界までリソースを利用する構成では、わずかな業務増加や一時的な処理遅延によって、性能要件を満たせなくなる可能性があります。
一方、必要以上に大きな余力を持たせれば、コストが増加します。
何%の余力を確保すべきかを一律に決めることはできません。業務の重要度、増加予測の確度、障害時の運用方針、追加リソースを準備するまでの期間などを踏まえ、設計の初期段階で関係者間の合意を取ります。
2.机上サイジングと実機サイジングを使い分ける
サイジング手法は、大きく机上サイジングと実機サイジングに分けられます。
机上サイジング
机上サイジングは、過去のシステム実績、類似システムの処理能力、製品ベンチマーク、ベンダーの推奨値などを使って、必要リソースを推定する方法です。
要件定義や提案段階など、アプリケーションがまだ存在しない時点でも概算できる利点があります。
一方、次の条件が変わると精度は低下します。
-
アプリケーションの処理方式
-
SQLやデータモデル
-
ミドルウェア構成
-
CPUアーキテクチャ
-
ストレージ性能
-
仮想化やコンテナの構成
-
外部サービスとの通信
机上サイジングは、概算費用の算出や検証環境の候補選定には有効ですが、最終的な構成を決める根拠としては不十分な場合があります。
実機サイジング
実機サイジングでは、プロトタイプや開発中のアプリケーションを実際に動かし、負荷を与えて処理能力を測定します。
測定対象は、本番導入予定のサーバーと完全に同一である必要はありません。
検証環境で得られた1コア当たりの処理量、CPU使用率、メモリ使用量、TPSなどを基に、本番環境で必要となるリソースを推定する方法もあります。
ただし、CPUベンチマークの比率だけで処理能力を換算するのは危険です。オンライン処理の性能は、CPUだけでなく、データベース、ストレージ、ネットワーク、ロック、コネクションプールなどにも左右されます。
ベンチマークによる換算は補助情報とし、可能な限り本番に近い構成で最終確認を行います。
実機サイジングでは、CPUコア数やカタログスペックだけで検証機を選定すると、実際のアプリケーション特性と合わない場合があります。CPUアーキテクチャや並列処理能力を、アプリケーションがどのように利用するのかまで確認する必要があります。
実際に、Sun Fire T1000を使った性能検証で、アプリケーションがCPUのハードウェアスレッドを十分に活用できず、想定した処理性能を得られなかったことがあります。検証サーバーの選定だけでなく、アプリケーションの処理方式も見直し、処理を並列化することで性能要件を満たしました。
このときの検証と見直しの経緯は、「システム基盤エンジニアの仕事」の「基盤設計は必要なリソースを決めるところから始まる」で詳しく紹介しています。
3.検証内容を確定する
実機サイジングでは、負荷ツールを動かす前に、何を確認するのかを定義します。
代表的な検証項目は次のとおりです。

サイジングでは、通常時とピーク時を確認するだけでは足りません。
ピーク時の負荷を処理できたとしても、その負荷が性能限界の直前であれば、わずかな業務増加や一時的な処理遅延で性能問題が発生します。
負荷を想定ピークよりも高い水準まで段階的に増やし、システムの限界点を確認する必要があります。
4.性能測定環境を確定する
性能測定結果を評価するには、測定環境と本番環境の差異を明確にしておかなければなりません。
最低限、次の情報を整理します。
サーバー構成
-
CPUの種類、コア数、クロック
-
メモリ容量
-
ストレージ構成
-
ネットワーク帯域、通信先までのレイテンシ
-
仮想マシンやコンテナのリソース制限
ソフトウェア構成
-
OS
-
Webサーバー
-
アプリケーションサーバー
-
JVMやランタイム
-
データベース
-
JDBCドライバー
-
フレームワーク
-
負荷生成ツール
ミドルウェア設定
-
Webサーバーの最大同時接続数
-
アプリケーションサーバーのスレッドプール
-
データベースのコネクションプール
-
JVMヒープサイズ
-
タイムアウト
-
キュー長
-
キャッシュ設定
-
ログ出力レベル
データ条件
-
テーブルごとのレコード件数
-
インデックス構成
-
データの偏り
-
1処理当たりの検索件数
-
更新件数
-
本番想定データ量との差異
性能測定時のパラメーターは、測定結果へ直接影響します。
例えば、コネクションプールの最大数が小さければ、CPUに余裕があっても接続待ちが発生します。スレッドプールを過度に増やせば、同時処理数は増えてもCPU競合やメモリ消費が拡大する可能性があります。
測定条件を記録せず、TPSやレスポンスタイムだけを残しても、後から結果を再現できません。
5.負荷モデルを作成する
負荷モデルは、実機サイジングで最も重要な要素です。
負荷モデルとは、単に同時稼働VUser数を決めることではありません。
どの業務を、どの割合で、どの間隔で実行するのかを定義したものです。
負荷モデルには、主に次の要素を含めます。
業務シナリオと業務トランザクション
負荷試験では、システムで実際に行われる画面遷移やAPI呼び出しを業務シナリオとして再現します。
例えば、次の三つの業務を持つシステムを考えます。

ここで示す比率は、負荷ツールが開始する業務トランザクション数の構成比です。過負荷時には業務ごとのレスポンスタイムやエラー率が異なるため、正常終了した業務トランザクション数の比率は70対20対10からずれる場合があります。
検索処理だけを大量に実行しても、実際の業務負荷は再現できません。
更新処理には、排他制御、トランザクションログ、インデックス更新、キャッシュ無効化など、参照処理とは異なる負荷が発生します。
実際の利用割合を確認し、複数の業務を組み合わせて負荷を与える必要があります。
本記事では、一つの画面操作または一つのAPI処理など、性能要件を判定する単位を「業務トランザクション」、複数の業務トランザクションを順番に実行する一連の操作を「業務シナリオ」と呼びます。
例えば、一覧検索から対象データを選択し、詳細確認と更新を行う一連の操作を業務シナリオとして定義します。業務シナリオと、それを構成する業務トランザクションの関係を次の図に示します。

この業務シナリオには、一覧検索、詳細参照、更新実行といった複数の業務トランザクションが含まれます。
思考時間
利用者は、画面が表示された直後に次の操作を行うわけではありません。
内容の確認や入力に数秒から数十秒を要します。この時間を思考時間と呼びます。
本記事では、各業務トランザクションの完了後、次の業務トランザクションを開始するまでの待機時間、すなわち画面遷移の間のユーザーの操作待ち時間を思考時間として扱います。
実際の利用者の操作間隔にはばらつきがあるため、すべてのVUserへ同じ思考時間を設定するだけでなく、一定範囲のランダム値や実際のアクセスログから得た分布を使う方法もあります。特にVUserの開始時刻や処理サイクルがそろうと、不自然なリクエスト集中が発生する可能性があります。思考時間の平均値だけでなく、ばらつきも実際の利用特性に合わせて設定します。
思考時間を設定せず、処理完了直後に次のリクエストを送信し続けると、実運用よりも極端に高い負荷になります。
一方、API連携やバッチ起動によるアクセスでは、人間の思考時間は存在しません。
利用者による画面操作と、システム間連携による処理を区別して設定します。
固定VUser型と到着率型
負荷の与え方には、大きく二つの考え方があります。
一つは、一定数の仮想ユーザーが、業務処理と思考時間を繰り返す方法です。本記事では、これを固定VUser型の負荷モデルとして扱います。利用者が画面を操作する一般的な業務システムでは、このモデルが実態に近い場合があります。
もう一つは、1秒当たりに何件のリクエストや業務処理が到着するかを指定する方法です。外部システムとのAPI連携、一斉通知後のアクセス、予約開始時刻の集中などでは、到着率を基準とした負荷モデルが適する場合があります。
固定VUser型では、レスポンスタイムが長くなると、各VUserが一つの処理を終えて次の処理を開始するまでのサイクルが長くなります。その結果、単位時間当たりに開始される業務トランザクション数も減少します。
到着率型では、レスポンスタイムが悪化しても、設定した到着率で新たな処理が投入されます。システムの処理能力を超えれば、実行待ちのキューや同時実行数が急激に増加する可能性があります。
それぞれの特徴は次の通りです。

負荷ツールの設定方法を先に決めるのではなく、実際の利用特性に合うモデルを選択します。
Ramp-up
テスト開始と同時に全ユーザーを接続すると、実運用では発生しない瞬間的な負荷集中が起きる場合があります。
段階負荷テストでは、一定時間ごとに同時稼働VUser数を増やします。
例えば、次のように負荷を上げます。

Ramp-upは、負荷ツールの起動集中を避けるためだけに設定するものではありません。実際のアクセス増加パターンを再現するための条件です。
上表はRamp-upの考え方を示す例です。実際のサイジングでは、想定ピークを超えて性能限界を確認できるまで、400、450と負荷段階を追加します。
始業時に徐々に利用者が増えるシステムと、予約開始時刻に一斉アクセスが発生するシステムでは、異なる負荷モデルが必要になります。
データ条件
同じSQLであっても、対象データが1万件の場合と1億件の場合では処理時間が異なります。
性能測定では、本番稼働時に想定されるデータ量を準備します。将来のデータ増加が性能へ与える影響を確認する場合は、数年後のデータ量を想定した測定も必要です。
データ件数だけでなく、値の偏りや検索条件も再現します。
すべての検索が1件だけ返すテストデータでは、数万件を返す検索や特定の値にアクセスが集中する処理を評価できません。
キャッシュの状態も測定条件に含める
データ量と検索条件が同じでも、キャッシュの状態によって性能測定の結果は変わります。特定のデータへアクセスが集中する負荷モデルでは、データベースやアプリケーションのキャッシュが効きやすく、実際以上に高い性能が得られる場合があります。一方、本番でアクセス対象が広く分散すると、キャッシュヒット率が低下し、データベースやストレージへのアクセスが増加する可能性があります。
性能測定では、実際のデータ分布とアクセスの偏りを再現するとともに、キャッシュが十分に生成されたウォーム状態と、キャッシュが効いていないコールド状態を区別します。どの状態の測定結果をサイジングに使用したのかを明記し、必要に応じて両方の状態で性能要件を確認します。
6.測定する性能指標を決める
オンライン処理の性能は、レスポンスタイムだけでは評価できません。
少なくとも、次の三つを同時に確認します。
-
スループット
-
レスポンスタイム
-
エラー率
本記事におけるTPSの定義
トランザクションという言葉は、HTTPリクエスト、データベースのCOMMIT、画面操作、業務シナリオなど、複数の意味で使われます。
本記事では、一つの画面操作または一つのAPI処理など、あらかじめ性能測定の単位として定義した業務処理が正常終了したものを「1業務トランザクション」とします。その1秒当たりの正常終了件数をTPSと呼びます。
HTTPリクエスト数やデータベースのCOMMIT回数、複数画面の操作を含む業務シナリオ全体の完了件数とは区別します。
例えば、一覧検索、詳細参照、更新実行をそれぞれ別の業務トランザクションとして定義した場合、各処理が正常終了するごとに1件として数えます。
スループット
スループットは、単位時間当たりに正常終了した業務トランザクション数です。
負荷を増やしたときにTPSが増加している間は、システムに処理余力があります。負荷を増やしてもTPSが伸びなくなった地点では、どこかのリソースが限界に達していると考えられます。
システムへ投入または到着した処理数と、正常終了したTPSは分けて記録します。
投入された処理には、タイムアウトやエラーとなった処理も含まれます。失敗した処理まで含めた値をそのままシステムの処理能力として評価すると、実際には業務が成立していないにもかかわらず、高い性能が出ているように見えるためです。
固定VUser型では、レスポンスタイムが延びると単位時間当たりに開始される処理数自体が減少します。到着率型では設定した到着数を維持するため、未処理のキューや同時実行数が増える可能性があります。負荷方式によって処理数の意味が異なるため、負荷条件と併せて評価します。
レスポンスタイム
レスポンスタイムとは、あらかじめ測定単位として定義した業務トランザクションについて、処理要求を開始してから応答が完了するまでの時間です。
本記事の性能曲線では、検索、登録、更新など、一つの画面操作または一つの業務処理を1業務トランザクションとして測定します。
複数の画面操作と思考時間を含む業務シナリオ全体の経過時間や、内部で実行される個別のHTTPリクエスト時間とは区別します。
画面内で複数のHTTPリクエストが実行される場合は、利用者の操作に対する応答が完了するまでの時間を業務トランザクションのレスポンスタイムとして評価します。個別HTTPリクエストの時間は、ボトルネックを分析するための補助指標として確認します。
レスポンスタイムは、平均値だけではなく、パーセンタイル値も確認します。
パーセンタイルとは、測定したレスポンスタイムを短い順に並べたとき、全体の何%がその値以下に収まるかを示す指標です。
例えば、レスポンスタイムを100件測定した場合、p95は短い方からおおむね95番目の値に相当します。p95が2秒であれば、「全処理の95%は2秒以内に完了し、残り5%は2秒を超えた」という意味です。
同様に、p50は全体の50%がその値以下に収まる境界であり、中央値に相当します。p99は全体の99%がその値以下に収まり、最も遅い1%を除いた応答時間の上限を示します。
平均レスポンスタイムが1秒であっても、一部の処理が10秒以上かかっている可能性があります。少数の遅い処理は平均値だけでは把握しにくいため、ユーザー体験や性能目標を評価する場合は、p95やp99を併用します。

業務トランザクション別に評価する
複数の業務を合算したレスポンスタイムだけでは、個別処理の性能劣化を見逃す場合があります。
例えば、実行割合が全体の5%程度しかない処理では、その処理の大半が遅延していても、すべての処理を合算したp95に問題が表れない可能性があります。
性能要件の合否は、全体値だけでなく、検索、登録、更新などの業務トランザクション別にも判定します。
重要な処理や利用頻度の低い処理については、個別にp95やp99、最大値を確認します。
エラー率
負荷が高くなると、タイムアウト、接続エラー、HTTPエラー、データベース接続エラーなどが発生することがあります。
負荷ツールが送信した総処理数だけを見ると、失敗した処理を含めて高い処理能力が出ているように見える場合があります。
次の値は分けて記録します。
-
システムへ投入または到着した処理数
-
正常終了したTPS
-
失敗した処理数
-
エラー率
-
エラーの種類
性能限界を超えた測定では、正常終了TPSが横ばいまたは低下しながら、レスポンスタイムとエラー率が上昇することがあります。
7.リソース使用状況を同時に測定する
性能曲線から限界点を見つけても、ボトルネックの場所までは判断できません。
負荷ツール側の測定値と併せて、サーバー、ミドルウェア、データベースの状態を監視します。
OS・サーバー
-
CPU使用率
-
CPUランキュー(実行待ち行列)
-
メモリ使用量
-
スワップ
-
ディスクI/O
-
ディスク待ち時間
-
ネットワーク帯域
-
通信レイテンシ
-
パケット再送
-
ファイルディスクリプター数
-
ディスク使用量
アプリケーション
-
実行スレッド数
-
スレッド待ち
-
JVMヒープ使用量
-
GC回数と停止時間
-
キュー滞留数
-
キャッシュヒット率
データベース
-
CPU使用率
-
DBセッション数
-
コネクションプール使用数
-
SQL実行時間
-
ロック待ち
-
I/O待ち
-
バッファキャッシュ
-
トランザクションログの生成量や待ち時間
-
OracleのREDOログ、PostgreSQLのWALなどの状態
-
実行計画
Web/APサーバーのCPU使用率が低いからといって、性能に余裕があるとは限りません。
データベース接続待ち、外部API待ち、ロック競合、ストレージI/O待ちが発生していれば、CPUをほとんど使わないままレスポンスタイムが悪化します。
性能測定では、負荷量、TPS、レスポンスタイム、エラー率、リソース使用率を同じ時系列で確認できるようにします。
8.性能曲線を作成する
測定データは、表だけでなくグラフにします。
横軸に負荷量、左右の縦軸にスループット(TPS)とレスポンスタイムを配置し、負荷の増加に伴う性能の変化を可視化したグラフを性能曲線と呼びます。
システムの性能要件と測定条件
ここからは、次の性能要件と測定条件を設定した架空のオンラインシステムを例に、性能曲線の読み方を説明します。

実際の性能試験では、検索、登録、更新などの業務トランザクション別にp95を評価します。
負荷段階ごとの測定結果
次の表では説明を簡潔にするため、各負荷段階において、主要業務トランザクションの中で最も遅かった処理のp95を「主要業務の最大p95」として掲載します。

図には次の情報を示します。
-
左軸:正常終了TPS
-
右軸:主要業務の最大p95
-
横軸:同時稼働VUser数
-
p95レスポンスタイム2秒の性能要件線
-
安全領域
-
要注意領域
-
性能限界を超えた領域
性能曲線の読み方
測定結果を基に、横軸を同時稼働VUser数、左縦軸を正常終了TPS、右縦軸を主要業務の最大p95とした性能曲線を作成します。

この測定結果では、同時稼働VUser数250までは、負荷の増加に応じて正常終了TPSがほぼ直線的に伸びています。300付近からTPSの伸びが鈍り、350ではほぼ頭打ちになります。
350では主要業務の最大p95が2秒を超え、エラー率も0.1%を上回っています。400以降は負荷を増やしても正常終了TPSが伸びず、450ではTPSが低下する一方、レスポンスタイムとエラー率がさらに上昇しています。
負荷を追加しても正常終了する処理量が増えず、利用者が待たされる時間と失敗する処理が増えている状態です。
固定VUser型では、レスポンスタイムが長くなると各VUserの処理サイクルが延び、単位時間当たりに開始・完了できる業務トランザクション数が減少します。限界超過域ではエラー率も上昇するため、正常終了TPSは、処理サイクルの長期化と正常終了率の低下の双方によって減少します。
このシステムの物理的な性能限界は、350から400付近にあると考えられます。
ここで注意すべき点は、性能限界まで本番で使用してよいわけではないことです。
性能要件が「すべての主要業務トランザクションのp95が2秒以内」「エラー率0.1%未満」であるため、300では要件を満たしますが、350では満たしません。
将来増加や一時的な負荷変動も考慮すると、1台当たりの安全な処理能力は250から300VUser程度として設計するのが妥当です。
性能限界と、設計上利用できる安全領域は分けて考えます。
安全領域は、CPU使用率など単一の指標だけで決めるものではありません。性能曲線の屈曲点より十分低い負荷であること、レスポンスタイムとエラー率が性能要件を満たすこと、CPU、メモリ、コネクションプール、I/Oなどの主要リソースに余力があることを併せて確認します。
実務では、屈曲点に対して一定の余裕を持たせる方法や、リソース使用率に管理上の上限を設ける方法が用いられますが、その値に一律の基準はありません。第1章で述べたとおり、負荷変動の大きさ、障害時の縮退、将来増加率を踏まえて、プロジェクトごとに合意します。
9.性能限界の原因を分析する
第7章で述べたとおり、性能曲線から、TPSが頭打ちになり、レスポンスタイムやエラー率が悪化する負荷段階を確認できても、その原因までは特定できません。性能限界を生じさせたボトルネックを見つけるには、リクエストが通過するシステム全体を処理経路に沿って確認する必要があります。
以下は、ロードバランサー、冗長化されたWeb/APサーバー、HA構成(冗長化)のデータベース、共有ストレージ、外部サービスから構成されるオンラインシステムの例です。

クライアントから送信されたリクエストは、ロードバランサーで振り分けられ、WebサーバーとAPサーバーを経由して、データベース、共有ストレージ、外部APIなどへ到達します。
この処理経路には、次のようなボトルネック候補があります。
-
ロードバランサーの接続数や処理能力の上限
-
Web/APサーバーのCPU競合、スレッド待ち、GC停止
-
APサーバー内のデータベースコネクションプール枯渇
-
データベースのロック競合、SQL待ち、I/O待ち
-
共有ストレージのI/O性能やネットワーク帯域
-
外部APIや認証サービスの応答待ち
-
ネットワークの帯域、レイテンシ、接続数などの上限
ネットワーク性能も、帯域だけでは判断できません。転送量に余裕があっても、同時接続数、新規接続数、OSやNATで使用できるポート、ロードバランサーや外部サービスの接続上限などが先に限界へ達する場合があります。帯域、レイテンシ、接続数、接続生成レートは、それぞれ別の指標として確認します。
性能曲線に屈曲点が現れたら、その負荷段階を測定した時間帯について、リソース使用率、ミドルウェア統計、データベースの待機イベント、アプリケーションログを同じ時系列で突き合わせます。
TPSの伸びが止まり、レスポンスタイムが急激に悪化した時点で、どのリソースの使用率や待ち時間が増加したのかを確認することで、性能限界を生じさせた原因を絞り込みます。
例えば、同時稼働VUser数が350を超えた地点で、次の状態が確認されたとします。
-
Web/APサーバーのCPU使用率は65%
-
JVMヒープには余裕がある
-
データベースコネクションプールは上限に到達
-
SQLの実行待ち時間が増加
-
データベースのI/O待ち時間が上昇
この結果から、Web/APサーバーのCPUやメモリには、まだ処理余力があると判断できます。一方、データベースコネクションプールが上限に到達し、SQL待ち時間とI/O待ち時間が増加しているため、性能限界の主な原因はデータベース側にある可能性が高いと考えられます。
この状態でWeb/APサーバーのCPUを増強しても、データベースへ接続できる処理数やSQLの処理能力は変わらないため、性能改善は期待できません。
確認すべき対象は、コネクションプールの上限値、接続待ち時間、SQLの実行計画、インデックス、ロック競合、データベースのCPUやI/O性能です。設定変更やSQL改善を行った場合は、同じ負荷条件で再測定し、性能曲線がどのように変化したかを確認します。
性能問題では、レスポンスタイムが悪化した場所と、実際にボトルネックが発生している場所が一致するとは限りません。利用者から見える現象は画面の遅延であっても、原因がデータベース、共有ストレージ、ネットワーク、外部サービスに存在するケースは珍しくありません。
CPU使用率だけを見てサーバー性能を判断するのではなく、リクエストが通過するシステム全体を確認し、どのリソースや待ち処理がシステムの処理能力を制限しているのかを特定する必要があります。
10.測定結果から必要台数を決める
性能限界を生じさせたボトルネックと、その構成で安全に利用できる範囲を確認したら、将来の業務量や障害時の条件を加えて必要台数を算定します。
設定変更、SQL改善、インデックス追加などによってボトルネックを解消した場合は、対策後に再測定し、その結果から安全領域を設定し直します。
性能曲線から1台当たりの安全な処理能力が分かれば、想定業務量と比較して必要台数を検討できます。
例えば、次の条件を想定します。

単純計算では、330を処理するために2台必要です。
一方、2台で運用しているときに1台が停止すると、残り1台へ330相当の負荷が集中し、安全処理能力250を超えます。
障害時にも性能要件を維持するのであれば、通常稼働に必要な2台をNとし、予備1台を加えた合計3台のN+1構成が候補になります。
ただし、1台で250を処理できるからといって、2台で必ず500を処理できるとは限りません。
Web/APサーバーを増やしても、システム全体の処理能力が台数に比例して伸びるとは限りません。データベースのロック競合やコネクション数の上限、共有ストレージのI/O、セッションストア、ネットワーク帯域、外部APIの処理上限など、複数のサーバーが共通して利用するリソースがボトルネックになるためです。
セッション情報を各Web/APサーバー間で複製する構成では、セッションデータのシリアライズやノード間転送も発生します。セッション情報が大きい場合や更新頻度が高い場合は、サーバーを増やすほどレプリケーションの通信量や処理負荷が増え、スケールアウト効率を低下させる可能性があります。
台数を増やした構成でも負荷測定を行い、共有リソースの使用率、ロック待ち、ネットワーク通信量、セッション同期処理を含めてスケールアウト効率を確認します。
例えば、1台構成で正常終了TPSが45、2台構成で81であれば、2台構成の処理能力は単純な2倍ではなく1.8倍です。
サーバー台数は、次の要素を合わせて決定します。
-
現在のピーク業務量
-
将来の業務増加
-
1台当たりの安全処理能力
-
スケールアウト効率
-
障害時に維持すべき性能
-
性能測定の誤差
-
想定外の負荷を吸収する余力
-
リソース増設に必要な時間
クラウドで動的な増設を行う場合は、オートスケーリングによって処理能力が追加されるまでの時間も考慮します。詳細は後述します。
11.稼働状態別に性能を測定する
アプリケーションは、サーバー起動直後と一定時間稼働した後で、性能が異なることがあります。
本章でいう起動後のウォームアップとは、サーバー起動後にクラスロード、JITコンパイル、データベース接続の生成、キャッシュ生成などが進み、定常的な性能へ移行するまでの過程を指します。
各負荷段階でTPSやレスポンスタイムが安定するまで待つ「負荷段階ごとの安定化時間」とは区別します。
起動直後には、次の処理が発生する場合があります。
-
クラスロード
-
JITコンパイル
-
JSPなどの初回コンパイル
-
データベース接続の生成
-
キャッシュの生成
-
設定ファイルの読み込み
-
コンテナの初期化
-
外部サービスとの初回接続
JITコンパイルとは、実行時に頻繁に使用される処理を機械語へ変換し、最適化する仕組みです。JavaのJVMや.NETなどでは、処理を繰り返す中で最適化が進むため、起動直後と定常状態で性能が異なる場合があります。
この時間帯は、CPU使用率やディスクI/Oが一時的に増加し、レスポンスタイムが悪化する可能性があります。
性能測定では、少なくとも次の状態を区別します。
-
サーバー起動直後
-
起動後のウォームアップ完了後
-
長時間稼働後
-
高負荷から通常負荷へ戻った後
起動後のウォームアップ前の結果だけで処理能力を評価すると、定常状態より低い性能として判定する可能性があります。
一方、ウォームアップ後だけを測定すると、再起動直後やオートスケーリングで新しいインスタンスが追加された直後の性能問題を見逃します。
長時間稼働による性能劣化も確認する
短時間の測定で性能要件を満たしていても、同じ性能を長時間維持できるとは限りません。メモリリーク、コネクションやスレッドの解放漏れ、ログや一時ファイルの増加、キャッシュの肥大化などによって、時間の経過とともにリソース使用量が増加し、性能限界へ到達する負荷量が低下する場合があります。
このような問題を確認するには、通常時またはピーク時に近い負荷を長時間継続するロングラン試験(耐久試験とも呼ばれます)を実施します。試験中はレスポンスタイムとTPSだけでなく、ヒープ使用量、GC、スレッド数、コネクション数、ファイルディスクリプター、ディスク使用量などが時間経過とともに増え続けていないかを確認します。
サイジングでは、測定開始直後の処理能力だけでなく、本番で想定する連続稼働時間において、その処理能力を安定して維持できるかも評価する必要があります。
本番運用で発生する状態を想定し、それぞれ測定します。
12.クラウド環境のサイジングで追加する観点
クラウド環境でも、性能要件と負荷モデルに基づいて実測する基本は変わりません。
一方、物理サーバーとは異なる観点が加わります。
インスタンスタイプ
vCPU数だけでなく、CPU世代、メモリ帯域、ネットワーク性能、ストレージ帯域を確認します。
同じvCPU数でも、インスタンスタイプによって業務処理能力が異なる可能性があります。
ネットワーク帯域とレイテンシ
クラウドでは、データベース、ストレージ、認証、外部APIなどの多くがネットワーク越しのサービスとして提供され、構成要素がアベイラビリティゾーンやリージョンをまたぐ場合もあります。このためネットワーク性能は、帯域とレイテンシを分けて評価します。
帯域は単位時間当たりに転送できるデータ量であり、大容量データの送受信に影響します。レイテンシは通信先との往復に要する時間であり、1回当たりのデータ量が小さくても通信回数が多いオンライン処理では、レスポンスタイムを大きく左右します。
特に、異なるアベイラビリティゾーン、リージョン、拠点にあるデータベースや外部API、認証サービスなどを同期的に呼び出す構成では、呼び出しごとの遅延が積み重なります。ネットワーク帯域に余裕があっても、通信距離や経路、外部サービス側の応答時間によって性能要件を満たせない場合があります。
性能測定環境と本番環境で通信先やネットワーク経路が異なる場合は、その差を測定条件として明記し、本番相当のレイテンシを含めて評価します。
バースト性能
一部のインスタンスタイプには、クレジット残高や一定の制約の範囲内で、一時的にCPU性能を高められるバースト機能があります。
短時間の測定だけを見ると十分な性能が出ていても、クレジットを消費した後や長時間のピーク負荷では、継続して同じ性能を出せない場合があります。
短時間の測定結果だけで判断せず、想定するピーク継続時間を含めて確認します。
オートスケーリング
オートスケーリングを採用していても、負荷が増えた瞬間に処理能力が増えるわけではありません。
次の時間を考慮します。
-
メトリクスの検知
-
スケールアウトの判断
-
インスタンスやコンテナの起動
-
アプリケーションの初期化
-
ヘルスチェック
-
ロードバランサーへの登録
-
キャッシュの生成
急激な負荷増加が予想される場合は、事前に台数を増やす方法や、最低稼働台数を多めに確保する方法も検討します。
マネージドサービスの上限
アプリケーション側のCPUに余裕があっても、マネージドデータベース、ロードバランサー、NAT、API、接続数、サービスクォータなどが限界になる場合があります。
アプリケーションサーバーだけでなく、システム全体の上限を確認します。
コスト性能比
クラウドでは、性能を満たす最小スペックを選ぶだけでなく、複数の構成についてコスト性能比を比較できます。
大きなインスタンスを少数配置する構成と、小さなインスタンスを複数配置する構成では、性能、可用性、拡張性、運用性が異なります。
性能測定結果と月額コストを合わせて評価します。
13.サイジングで起きやすい失敗
利用者数だけでサーバースペックを決める
利用者数だけでは、処理頻度や業務内容が分かりません。
TPS、処理比率、思考時間、データ量を含む負荷モデルへ変換する必要があります。
ログイン数と同時稼働VUser数を混同する
ログイン中の利用者全員が、常にサーバーへリクエストを送っているわけではありません。
実運用の利用率と、負荷ツール上で処理を繰り返す仮想ユーザー数を区別します。
負荷モデルの種類を意識しない
固定VUser型と到着率型では、過負荷時の挙動が異なります。
人による画面操作なのか、APIやイベントによる到着負荷なのかを確認し、実態に合うモデルを選びます。
通常時とピーク時だけを測定する
性能要件を満たしたことは確認できますが、性能限界までの余力が分かりません。
想定ピークを超える負荷まで段階的に測定し、性能曲線を作成します。
平均レスポンスタイムだけを見る
一部の利用者に大きな遅延が発生していても、平均値では見えにくくなります。
p95やp99、最大値、エラー率も確認します。
全業務を合算したp95だけを見る
実行割合の少ない処理は、全体のパーセンタイル値に問題が表れない場合があります。
検索、登録、更新などの業務トランザクション別にもレスポンスタイムを評価します。
エラーとなった処理を処理能力に含める
失敗した処理まで処理能力として評価すると、システムの性能を過大に見積もります。
投入または到着した処理数、正常終了TPS、エラー率を区別します。
負荷生成側の限界を見落とす
負荷生成PCやネットワークが先に限界へ達すると、対象システムの性能限界を正しく測定できません。
負荷生成側のCPU、メモリ、ネットワーク、同時接続数も監視します。
Web/APサーバーだけを監視する
実際のボトルネックがデータベースや外部サービスにある場合、Web/APサーバーを増強しても改善しません。
リクエストが通過するシステム全体を監視します。
測定条件を記録しない
設定値、データ量、シナリオ、実行時間が不明な測定結果は、再現も比較もできません。
性能結果と併せて測定条件を管理します。
測定ごとに初期条件が変わる
性能測定を繰り返すと、登録・更新処理によってテーブルのレコード件数が増え、ログ、一時ファイル、キャッシュ、統計情報などの状態も変化します。前回の測定で作成したデータが残ったまま次の測定を行うと、構成やパラメーターの違いではなく、測定開始時の状態の違いによって結果が変わる可能性があります。
段階負荷の比較や構成変更前後の比較では、データベースのスナップショットを復元するなど、原則として同じ初期データとシステム状態から測定を開始します。試験データを削除するだけでなく、キャッシュ、コネクション、ログ、統計情報など、測定結果に影響する状態も確認します。
一方、ロングラン試験では、データやログの蓄積による性能劣化そのものが確認対象となります。試験の目的に応じて、環境を初期化する測定と、状態を継続させる測定を明確に分けます。
1台の処理能力を台数分だけ掛ける
複数台構成では、共有リソースや負荷分散の偏りによって、性能が線形に増加しない場合があります。
実際の複数台構成でスケールアウト効率を測定します。
サイジング結果として残すべき成果物
サイジングを実施した後は、少なくとも次の情報を成果物として残します。

「サーバーは3台必要」という結論だけを残しても、後から根拠を確認できません。
どの性能要件に対し、どの負荷モデルで測定し、どの範囲を安全領域と判断したのかを追跡できる形にします。
まとめ:サイジングの本質は性能限界と安全領域を見極めること
オンライン処理のサイジングは、利用者数からサーバースペックを直接決める作業ではありません。
まず、通常時とピーク時の業務量、TPS、レスポンスタイム、処理の構成比、データ量、将来増加率を性能要件として整理します。次に、実際の業務に近い負荷モデルを作成し、負荷を段階的に増やしながら正常終了TPS、業務トランザクション別のレスポンスタイム、エラー率、リソース使用状況を測定します。
負荷モデルでは、ログイン数と同時稼働VUser数を区別し、人が操作するシステムなのか、一定の到着率でリクエストが発生するシステムなのかを踏まえて、負荷の与え方を選択します。
測定結果を性能曲線として可視化すると、システムが安定して処理できる範囲と、正常終了TPSが頭打ちになり、レスポンスタイムやエラー率が急激に悪化する性能限界が見えてきます。
必要なサーバー台数は、性能限界そのものではなく、性能要件を満たす安全領域を基準に決めます。将来の業務増加、障害時の縮退、スケールアウト効率、共有リソースの上限も考慮しなければなりません。
サイジング結果に求められるのは、CPUやメモリの数値だけではありません。
「この構成で、どの業務量まで、どの応答性能を維持できるのか」「業務量が増えた場合に、どのように拡張するのか」を説明できることが、性能設計と拡張性設計におけるサイジングの本質です。
関連記事
オンライン処理のサイジングで求めた性能要件や必要リソースは、その後のシステム構成や基本設計、性能検証へつながります。特に、実測結果をどのように設計へ反映し、将来の負荷増加に備えるかまで考えることが重要です。
- 基本設計で決めること
サイジングで決定したCPU、メモリ、サーバー台数、冗長構成などを含め、基本設計で何を決めるのかを実務の観点から解説しています。

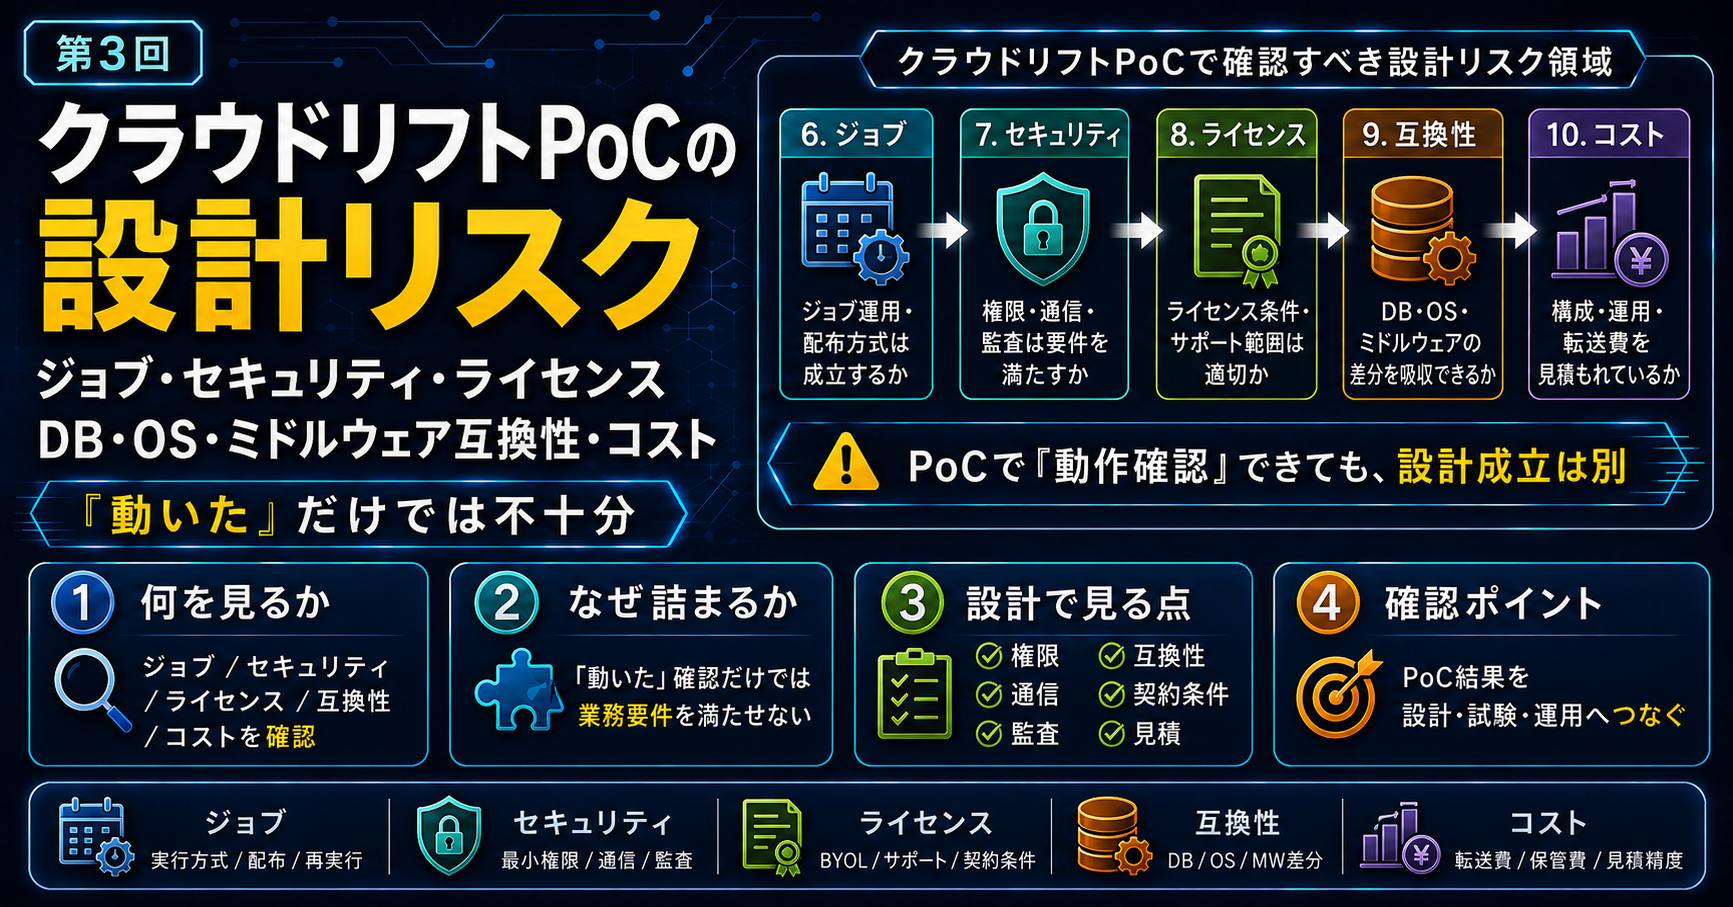
- 【第2回】クラウドリフトPoCの設計リスク|可用性・性能・ストレージ・バックアップ・監視
クラウドリフトのPoCで、単に「動くこと」を確認するだけでは不十分な理由を、可用性、性能、ストレージ、バックアップ、監視の観点から解説しています。サイジングで実測値を構成選定の根拠にする考え方ともつながる内容です。
- EC2を止めただけなのに再作成?Auto Scaling運用の落とし穴|クラウドの自動化は、作業者の意図までは読んでくれない
将来の負荷増加に対して、いつ、どのようにサーバーやコンテナを増やすのか。スケールアウトの考え方や、Auto Scalingを設計するときに確認すべきポイントを解説しています。


コメント