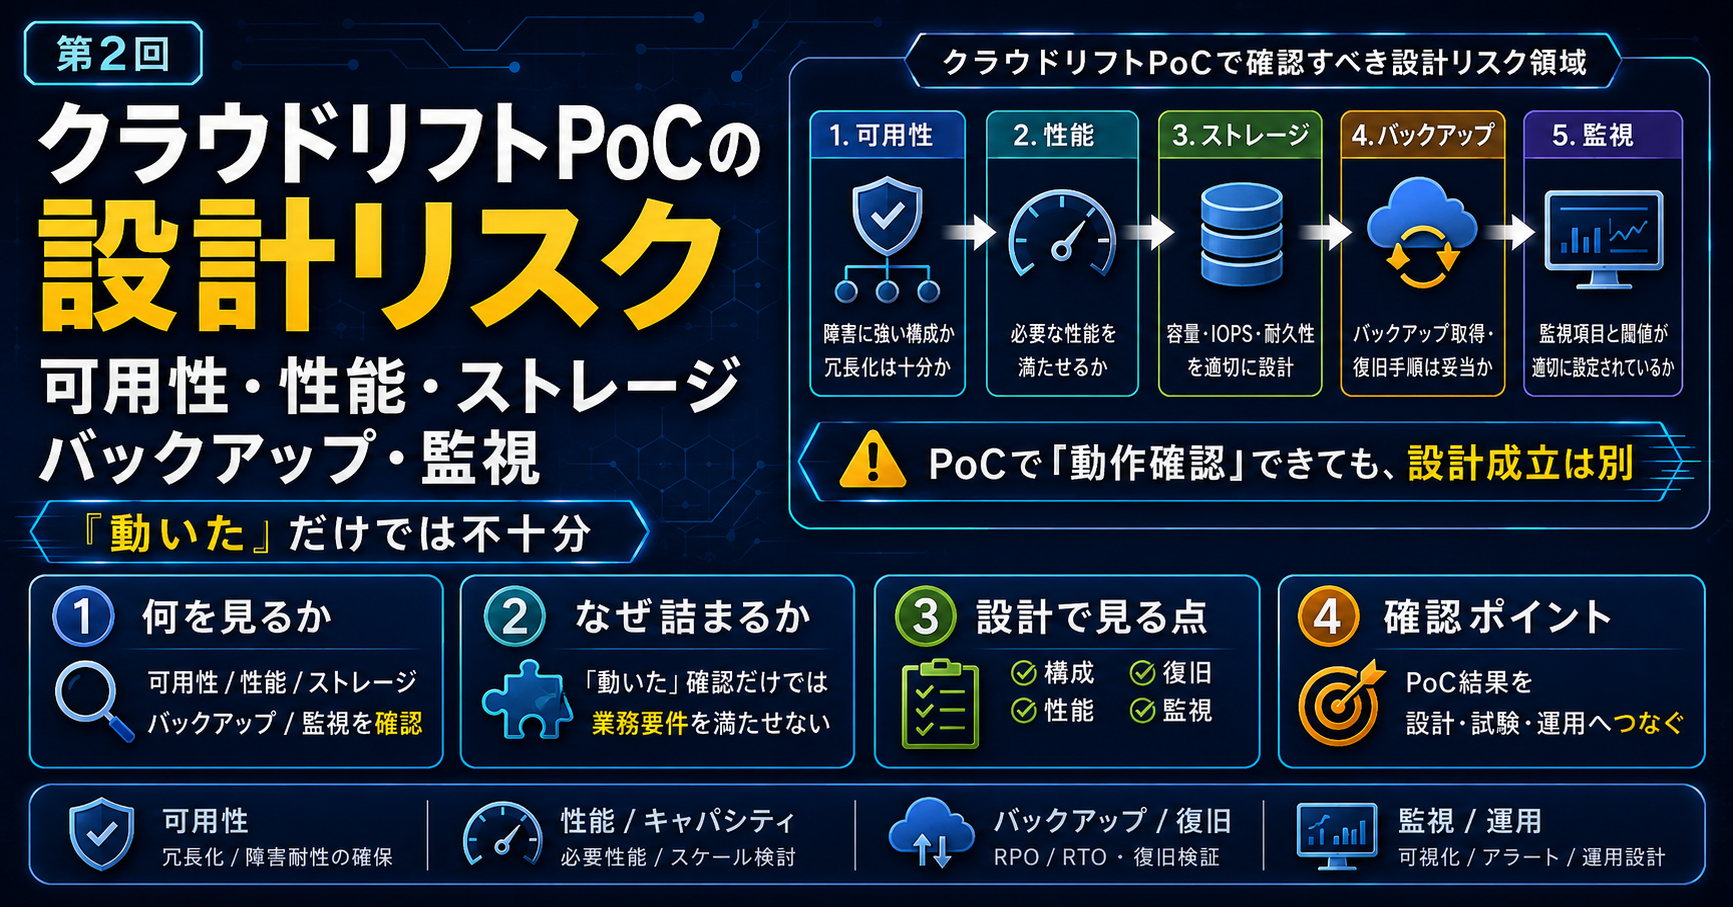
この記事は「クラウドリフトPoCで設計リスクを潰す」全3回シリーズの第2回です。
本シリーズでは、クラウドリフトのトラブルを個別の設定ミスとしてではなく、構築前に残った設計リスクという観点から整理します。
-
【第1回】クラウドリフトの失敗は構築前に始まっている|PoC不足が手戻りを招く理由
PoC不足が、なぜ構築・試験・運用での手戻りにつながるのか -
【第2回】この記事
クラウドリフトPoCの設計リスク|可用性・性能・ストレージ・バックアップ・監視 -
【第3回】クラウドリフトPoCの設計リスク|ジョブ・セキュリティ・ライセンス・DB互換性・コスト
ジョブ/セキュリティ/ライセンス/DB・OS・ミドルウェア互換性/コストの5領域
※この記事は途中まで無料でお読みいただけます。続きはnote(有料)で公開しています。
はじめに
「PoCでは問題なかったのに、構築に入ったら次々と課題が出てきた」
クラウドリフトでは、こうしたことが実際に起こります。
- EC2上でアプリが起動した。
- EFSでファイルを読み書きできた。
- RDS上で主要な機能が動いた。
- バックアップジョブも正常終了した。
それでも、本番でその方式が成立するとは限りません。
「動いた」という確認と、「その方式で設計・試験・運用まで成立する」という確認は別だからです。
例えば、
- 接続はできても本番負荷では性能が出ない。
- 共有ストレージとして使えても、既存アプリのファイル更新方式とは合わない。
- バックアップは取得できても、必要な時間内にリストアできない。
- 監視できても、Auto Scalingや障害復旧後のサーバーを運用対象として正しく引き継げない。
PoCで見るべきなのは、AWSサービスが使えるかどうかだけではありません。
その構成で業務を継続できるか。後工程の設計・試験・運用まで成立するか。
第2回では、その中でもクラウド基盤を成立させるための次の5領域を扱います。
- 可用性・信頼性
- 性能・キャパシティ
- ストレージ
- バックアップ
- 運用・監視
これらは、机上で作ったチェックリストではありません。
実際のクラウドリフト案件でPoCや設計を進める中で、事前に確認できた論点と、後工程で初めて表面化した問題の両方をもとに整理しています。
例えば、別AZで起動したEC2がOS内部のルート情報によって通信できなかったケースや、CloudWatch LogsのS3エクスポート、EBS容量縮小、Auto Scaling後の運用などです。
重要なのは、個々の事象そのものではありません。
「PoCの段階で、何を確認しておけば設計リスクとして潰せたのか」
という視点です。
ここからは、可用性・性能・ストレージ・バックアップ・運用・監視の5領域について、PoCで確認すべき点と、見落とした場合の後工程への影響を整理します。
PoC観点を強化するきっかけになった個別事例
以下は、クラウドリフトPoCの観点を見直すきっかけになった個別事例です。
本記事では、これらの個別事例に加え、PoCで事前に潰せた設計論点も含めて、クラウドリフトPoCで見るべきリスクを整理しています。
-
-
- 【AWS】別AZで起動したWindowsが通信不能に|原因はVPCではなく「OS内のルート情報」だった
- CloudWatch Logsのログエクスポートが失敗した話|「ジョブは動く」と「運用で回る」は別物
- バックアップ設定の「5日保存」は、5営業日分とは限らない|AWS Backupの保持期間から考える、詳細設計の落とし穴
- EBSは増やせても、簡単には減らせない|RHEL環境で見落とした「容量縮小=ディスク移行」という現実
- S3バケットにあるのに取得できない|クロスアカウント構成で見落とした「オブジェクト所有者」の罠
- RHELで使えた設定方法が、Amazon Linuxでは使えなかった|MTU設定に見る、OS差分と永続化確認の落とし穴
- EBSは見えているのにマウントできない?|AMIコピーで起きた落とし穴
- AMIからRHELインスタンスを起動したらSSHログインできなくなった|cloud-initが上書きする設定を知らないと、復旧以前に入れなくなる
- EC2を止めただけなのに再作成?Auto Scaling運用の落とし穴|クラウドの自動化は、作業者の意図までは読んでくれない
- クラウドが「障害を吸収した」のに、なぜOSが死んだのか|IaaS/SaaS境界の落とし穴
-
なお、第3回では購入者特典として、10項目全体を整理したExcel資料「クラウドリフトPoC設計リスクチェックリスト」も添付します。
PoC計画、設計レビュー、リスク洗い出しのたたき台として使えるようにしています。
可用性・信頼性
EC2が起動しただけでは、業務復旧とは言えない
クラウドリフトでは、可用性設計が軽く見られることがあります。
- EC2は再作成できる。
- RDSはMulti-AZにできる。
- Auto Scalingを使えば復旧できる。
- ロードバランサー配下に置けば切り替えられる。
マネージドサービスがすべてやってくれるように見えるからです。
しかし、業務システムの復旧は、EC2が起動することではありません。
業務処理が再開できることです。
Auto Scalingを使う場合でも、EC2が新しく作られれば終わりではありません。
実際の復旧方式では、障害ノードをロードバランサー配下から切り離し、AMIから新規EC2を作成し、cloud-initやUser Dataを使って初期設定を反映し、ホスト名を付与し、DNSに登録し、監視エージェントやミドルウェアを起動する、といった一連の処理が必要になります。
ここで重要なのは、単にスクリプトを書けるかどうかではありません。
実行タイミングです。
ホスト名の付与が監視エージェントやミドルウェアの起動より後になると、誤ったホスト名でサービスが起動し、監視登録やジョブ実行対象の認識がずれることがあります。
そのため、cloud-initのどの段階で設定を反映するのか、User Dataで実行するのか、設定ファイル側で制御するのか、サービス起動順序をどうするのかまで確認しなければなりません。
さらに、ロードバランサーのヘルスチェックに戻す条件、監視対象への再登録、ジョブ実行対象としての認識、ログ収集先の切替、障害解析のために旧EC2を残すかどうかも決める必要があります。
Auto Scalingは復旧方式の一部であって、復旧方式そのものではありません。
AWS側が支援してくれるのは、インスタンスの再作成、ロードバランサーのヘルスチェック、マネージドサービスの切替といった基盤機能の部分です。
一方で、作り直されたEC2を業務システムとして使える状態に戻す設計は、利用者側の責任です。
ホスト名、DNS登録、監視エージェント、ミドルウェア起動順序、ジョブ実行対象への再登録、ログ収集先の切替、復旧後の業務確認は、クラウドが自動で判断してくれるわけではありません。
PoCでは、EC2が作られるかではなく、作られたEC2が業務システムの構成要素として正しく組み込まれるかを確認する必要があります。
この復旧の流れは、文章だけでは見落とされやすいため、図に整理すると次のようになります。

保守停止と障害検知は分けて考える
Auto Scalingでは、EC2が意図せず停止した場合に、期待する台数を維持するため、新しいEC2が作られることがあります。
これは可用性の観点では便利です。
しかし、運用の観点では注意が必要です。
保守作業としてEC2を停止したいだけでも、停止方法や事前の切り離し手順が適切でなければ、Auto Scaling側では障害や不足状態として扱われることがあります。
作業者は「保守のために止めた」と思っている。
しかし、Auto Scalingは期待台数を維持する仕組みとして、元の台数へ戻そうとします。
その結果、意図しないEC2が作られ、監視、ジョブ、ログ、ライセンス、コストの前提が崩れることがあります。
このようなことが起こります。
つまり、Auto Scalingを使うなら、障害時にどう復旧するかだけでなく、保守時にどう止めるかも設計しなければなりません。
- 保守作業時には、Auto Scalingグループの期待台数を変更するのか。
- インスタンス保護を使うのか。
- スケーリングを一時停止するのか。
- ロードバランサーから切り離して作業するのか。
- 作業後にどう戻すのか。
この運用手順を決めずにAuto Scalingを使うと、「自動復旧」が「作業者の意図しない再作成」になります。
クラウドの自動化は、作業者の意図までは読んでくれません。
PoCでは、障害時の自動復旧だけでなく、保守停止、再起動、切り離し、再登録、戻し忘れの検知まで確認する必要があります。
別AZで起動できても、通信できるとは限らない
別AZでEC2を起動できたとしても、通信できるとは限りません。
VPC、サブネット、ルートテーブル、Security Groupが正しく見えていても、OS内に残っている静的ルート、永続ルート、NIC設定、メトリック設定が移行後のネットワーク構成と合わないことがあります。
その場合、AWS側のネットワーク設定だけを見ても原因にたどり着けません。
クラウド移行では、ネットワークの問題を見るときに、どうしてもVPC側へ目が向きます。
- ルートテーブルは正しいか。
- Security Groupは開いているか。
- NACLで落ちていないか。
- サブネットの関連付けは正しいか。
- Transit GatewayやVPN経路は正しいか。
もちろん、それらは重要です。
しかし、OS内に固定で設定されていたルート情報、古いネットワークアダプタ前提の設定、特定AZや特定サブネットのIPを前提にした設定が残っていると、AWS側のネットワークが正しくても通信できないことがあります。
特にWindowsサーバでは、GUI上のネットワーク設定だけでなく、永続ルート、メトリック、複数NIC構成、過去に追加した静的経路などが影響することがあります。
PoCでは、EC2が起動するか、疎通確認が一度通るかだけでなく、OS内のルート情報、再起動後の永続化、AZ変更後の通信経路まで確認する必要があります。
「AWS側の設定は正しいのに通信できない」という状態は、原因調査に時間がかかります。
だからこそ、PoCの段階で、OS内のネットワーク前提まで確認しておく必要があります。
名前解決は、クラウドリフトにおける最重要設計論点
クラウドリフトでは、名前解決が非常に重要です。
オンプレでは、サーバ名、IPアドレス、DNS登録、参照経路が長期間固定されている前提で運用されていることがあります。
しかし、クラウドでは、EC2の再作成、AZ変更、復旧方式、切替方式によって、同じIPアドレス、同じ物理名、同じ参照経路で戻ってくるとは限りません。
そのため、必要に応じてDNSやRoute 53のレコードを書き換える設計が必要になります。
ここで注意すべきなのは、「DNSを書き換えればよい」という単純な話ではないことです。
- 参照元がAWS内のEC2なのか。
- 別VPCなのか。
- オンプレミスのクライアントなのか。
- AD DNSを見ているのか。
- オンプレDNSからRoute 53へフォワードしているのか。
- Route 53 Private Hosted Zoneを直接見ているのか。
この経路によって、復旧時に変更すべき場所が変わります。
特にハイブリッド構成では、Route 53 ResolverのInbound endpoint、Outbound endpoint、転送ルールの設計も重要になります。
- オンプレ側からAWS内の名前を解決するのか。
- AWS側からオンプレDNSへ問い合わせるのか。
- どのドメインを、どのDNSへフォワードするのか。
また、名前解決は成功するか失敗するかだけでなく、問い合わせにどれくらい時間がかかるかも重要です。
オンプレDNS、Route 53 Resolver、AD DNS、別VPCのDNSをまたぐ構成では、フォワード先の設定、再帰問い合わせ、リトライ挙動によって、名前解決の遅延がアプリケーションの応答時間やタイムアウトに影響することがあります。
この設計を誤ると、AWS側では名前解決できているのに、オンプレ端末や業務サーバからは名前解決できない、という状態になります。
場合によっては、クラウド側のレコードを変更したつもりでも、参照元が別のDNSサーバを見ていて、期待した名前解決にならないことがあります。
ここを知らずに進むと、基盤結合試験まで発見されないことがあります。
システムテストのユースケースが甘いと、本番切替後に初めて通信できない、接続先が違う、名前解決できない、という形で発覚する可能性があります。
クラウドリフトでは、DNSは単なる付帯設定ではありません。
復旧方式、切替方式、運用方式そのものに関わる設計要素です。
DNSキャッシュとTTLも見落としやすい
切替直後は、クライアントやアプリケーションが古い名前解決結果をキャッシュしているため、一見すると通信できているように見えることがあります。
しかし、TTLが切れて再度名前解決が行われたタイミングで、参照先DNS、Route 53、オンプレDNS、Resolver経路、レコード状態のどこかに不整合があると、名前解決エラーや接続先誤りとして表面化します。
また、OS、JVM、ミドルウェア、接続プール、プロキシなどが名前解決結果や接続先情報を保持していると、Route 53側のTTLだけを見ていても切替挙動を説明できません。
DNS再解決を契機に接続先が変わり、TLS証明書のホスト名検証、DB接続、認証処理、接続プールの再接続で失敗することもあります。
特にアプリケーションサーバやバッチ処理では、起動時に解決した接続先情報をプロセス内で保持し続けることがあります。
その場合、DNSレコードを変更しても、アプリケーションが再起動されるまで新しい接続先を見に行かないことがあります。
逆に、TTL経過後に再解決された瞬間に、今まで見えていた接続先と別の接続先へ向かい、初めて問題が出ることもあります。
PoCでは、切替直後だけでなく、TTL経過後、キャッシュクリア後、アプリ再起動後、接続プール再作成後の挙動まで確認しておく必要があります。
DNSは、切替直後に疎通できればよいわけではありません。
TTLが切れた後、キャッシュが消えた後、アプリが再接続した後に、同じように業務が継続できるかを見る必要があります。
RDS Multi-AZも「切り替われば終わり」ではない
RDSがフェイルオーバーして待機系へ切り替わった場合、DBとしては復旧していても、Web/APサーバとのAZ配置が変わることがあります。
Web/APはAZ-A中心に残り、RDSのプライマリだけAZ-Bへ切り替わると、Web/APからDBへの通信がAZまたぎになります。
実務では、切替直後は一時的な縮退状態として許容し、業務影響を見ながらフェイルバックする方針を取ることもあります。
また、DBがフェイルオーバーしても、アプリケーション側が正しく再接続できるとは限りません。
- コネクションプールが古い接続を保持したままになる。
- 接続リトライの回数や間隔が足りない。
- DNS再解決が走らない。
- 一時的な接続断をアプリが異常終了として扱う。
このような場合、RDSとしては復旧していても、アプリケーションは接続エラーを出し続けることがあります。
PoCや障害試験では、DBの切替だけでなく、アプリ側の再接続、リトライ、コネクションプールの挙動まで確認する必要があります。
ここで重要なのは、切り替わるかどうかではありません。
切り替わった後の配置で、画面応答、バッチ処理、帳票処理、データ転送量、運用手順に問題が出ないかを確認することです。
PoCで見るべき観点
- 障害時に、どの単位で、どこまで自動復旧するのか
- そのEC2は、自動で作り直してよいサーバなのか
- Auto Scaling後に、ホスト名、DNS登録、OS設定、監視エージェント、ミドルウェア起動まで再現できるか
- cloud-initやUser Dataの実行タイミングが、サービス起動順序と矛盾していないか
- ロードバランサーのヘルスチェック、切り離し、復帰の条件は明確か
- 保守作業としてEC2を停止した場合と、障害として停止した場合を、Auto Scalingがどう扱うか
- 保守時にスケーリング停止、期待台数変更、インスタンス保護などの運用手順が必要か
- 別AZ起動後に、OS内の静的ルート、永続ルート、NIC設定、メトリック設定が移行後の構成と合っているか
- 参照元ごとに、どのDNSサーバを経由して名前解決しているか
- DNS問い合わせの遅延、リトライ、再帰問い合わせがアプリケーション応答やタイムアウトに影響しないか
- Route 53 ResolverのInbound/Outbound endpoint、転送ルールがハイブリッド構成に合っているか
- EC2再作成、AZ変更、切替後に、DNSやRoute 53のレコード変更が必要になるか
- DNSキャッシュやTTL経過後に、参照元から再度正しく名前解決できるか
- OS、JVM、ミドルウェア、接続プール、プロキシが独自に名前解決結果を保持していないか
- RDSがフェイルオーバーした後、Web/APとのAZ配置や通信経路に問題が出ないか
- DB切替後に、アプリ側の再接続、リトライ、コネクションプールの再作成が正しく行われるか
- 縮退状態を許容するのか、フェイルバックするのか
- 復旧後に何を確認すれば業務再開と言えるのか
可用性は、サーバが再起動することではありません。
自動復旧できるものと、手動で戻すべきものを切り分けること。
切り替わった後の配置、性能、縮退運用、フェイルバック方針まで確認すること。
そして、業務が再開できる状態を説明できること。
ここまで見て、初めてクラウドリフトにおける可用性設計です。
性能・キャパシティ
動いたことと、業務時間内に処理できることは違う
性能面において最も危険なのは、単純な正常系テストで『動いた』と満足してしまうことです。
- EC2上でアプリが起動した。
- DBに接続できた。
- バッチが1回流れた。
- ファイルを読み書きできた。
しかし、それだけでは性能要件を満たしたことにはなりません。
現場では、日次の夜間バッチだけが重いとは限りません。
週次処理、月次処理、締め処理、大量帳票、ファイル集計、洗い替え処理など、特定日だけ極端に重くなる処理があります。
通常日の軽いデータや単発の小さな検証だけで判断すると危険です。
性能が出るかどうかは、インスタンスタイプ選定とも切り離せません。
オンプレからクラウドへ移行する場合、既存サーバのCPU、メモリ、ディスクI/O、ネットワーク使用量をそのまま見ても、クラウド上の適切なインスタンスタイプが自動的に決まるわけではありません。
オンプレ環境では、CPU性能をSPECintや独自の換算指標で見ていたとしても、AWS上ではインスタンスタイプごとにvCPU数、メモリ量、ネットワーク性能、EBS帯域、CPU世代、ファミリー特性が異なります。
そのため、単純に「CPUが何個あるからこのタイプ」「メモリが何GBあるからこのタイプ」と決めるのは危険です。
バッチサーバのように、大量データを読み込み、ソートし、一時領域を使い、一定時間内にまとめて処理するサーバでは、CPUだけでなくメモリやI/Oが効いてくることがあります。
一方で、Web/APサーバのように、1件あたりの処理は軽くても、多数のリクエストやトランザクションをさばくサーバでは、vCPU数、同時実行性能、スレッド数、コネクションプールの設計が効いてくることがあります。
- CPUが足りないのか。
- メモリが足りないのか。
- I/Oが詰まっているのか。
- ネットワークが詰まっているのか。
- 同時実行数に対してスレッドやコネクションプールが足りないのか。
ここを見ずにインスタンスタイプだけを上げると、コストだけが増えて、性能問題が解消しないことがあります。
また、拡張性を残すことも重要です。
最初からそのファミリーの最大サイズ、または上限に近いタイプを選んでしまうと、負荷が増えたときに同じ考え方でスケールアップできません。
「性能が足りなければタイプを上げればよい」と考えていたのに、すでに上限に近いタイプを選んでいたため、設計変更、構成変更、スケールアウト方式の見直しが必要になることがあります。
PoCでは、今の負荷を処理できるかだけでなく、将来の増加分をどこまで同じ構成で吸収できるかも確認しておく必要があります。
- 同じファミリー内のサイズ変更で対応できるのか。
- メモリ最適化、コンピューティング最適化、汎用系など、ファミリー選定から見直す必要があるのか。
- スケールアップではなく、スケールアウトや処理分散を考えるべきなのか。
この判断は、性能設計であり、同時にコスト見積やキャパシティ管理の前提にもなります。
PoCで見るべきなのは、単に「このタイプで動いたか」ではありません。
- このタイプで本番負荷に耐えられるのか。
- 将来の増加に対して拡張余地があるのか。
- 同じファミリー内で上げればよいのか、ファミリー選定から見直すべきなのか。
- 見積、性能試験計画、キャパシティ管理の前提として説明できるのか。
ここまで確認しないと、設計段階でインスタンスタイプを決められず、試験やサービス開始後に「タイプを変えれば済むと思っていたのに、そう簡単ではなかった」という状態になります。
EFSを使う場合、標準的なバースト前提では、重いバッチ処理を安定して処理できないことがあります。
EFSのバーストスループットは、クレジットの蓄積と消費で動きます。
軽い処理を続けている間はクレジットが回復しますが、重いバッチを集中的に流すとクレジットを一気に使い切り、ベースラインスループットまで落ちることがあります。
また、EFSの性能を見るときは、単純な転送量だけでは不十分です。
- 読み取り中心なのか、書き込み中心なのか。
- 大きなファイルを少数扱うのか、小さなファイルを大量に扱うのか。
- `ls`、`find`、属性確認、ディレクトリ走査のようなメタデータ操作が多いのか。
この違いによって、同じデータ量でもボトルネックの出方は変わります。
特に小さなファイルが大量にあり、バッチ処理でディレクトリを再帰的に走査するような場合、データ転送量よりもメタデータ操作が効いてくることがあります。
そのため、通常日のPoCでは問題なかったのに、月次締め処理や大量ファイル処理だけ極端に遅い、という現象が起こります。
バッチ処理がEFSから大量のファイルを読み込み、CPUとI/Oを同時に使い切るような処理であれば、エラスティックスループットやプロビジョンドスループットを検討する必要があります。
重要なのは、単に性能が出るかどうかではありません。
- 最も重い処理を、最も重い条件で流したときに、どのスループットモードが必要なのか。
- 一時的に性能を上げる運用が可能なのか。
- 処理後に下げられるのか。
- 変更に制約はないのか。
- 戻し忘れた場合にどれだけ課金されるのか。
- 見積上、その運用を説明できるのか。
ここまで含めて検証する必要があります。
もし、インフラ側の調整だけでは性能要件を満たせない場合は、バッチ処理の分割、コミット単位の見直し、ソート処理の方式、DBアクセス方式、ログ出力方式など、アプリケーションや処理方式の見直しに波及します。
性能PoCの最大のポイントは、軽い処理で「動いた」と確認することではありません。
最も重い処理を、最も重い条件で流し、必要な性能、構成、課金、運用手順、そしてアプリ改修要否まで判断することです。
PoCで見るべき観点
- 週次・月次・締め処理など最も重いバッチを本番相当データで流せるか
- 既存サーバのCPU、メモリ、I/O、ネットワーク使用量をもとに、アプリケーション特性に合ったインスタンスタイプやファミリーを選べているか
- バッチサーバ、Web/APサーバ、DBサーバなど、役割ごとにvCPU、メモリ、I/O、ネットワークの見方を分けているか
- 最初から最大サイズや上限に近いタイプを選んでおらず、将来のスケールアップ余地を残しているか
- 同じファミリー内のサイズ変更で足りるのか、ファミリー変更やスケールアウト設計まで必要になるのか
- EFS、EBS、DB、ネットワーク、EC2インスタンスのどこがボトルネックになるか
- EFSを使う場合、バースト、エラスティック、プロビジョンドのどのスループットモードが必要か
- 一時的に性能を上げ、処理後に下げる運用が現実的にできるか
- インフラ側の性能調整で足りない場合、アプリ改修や処理方式変更が必要になるか
- 読み取り/書き込み比率、大量小ファイル、`ls`/`find`などのメタデータ操作が性能ボトルネックにならないか
性能は、CPUやメモリの数字だけで決まるものではありません。
業務処理が、必要な時間内に、必要な量を、安定して処理できるか。
そして、その性能を必要なときだけ使い、不要なときにはコストを抑える運用ができるか。
ここまで見て、初めてクラウドリフトにおける性能設計です。
ストレージ
共有できることと、業務で使えることは違う
ストレージは、クラウドリフトPoCで大きな手戻りになりやすい領域です。
コメント