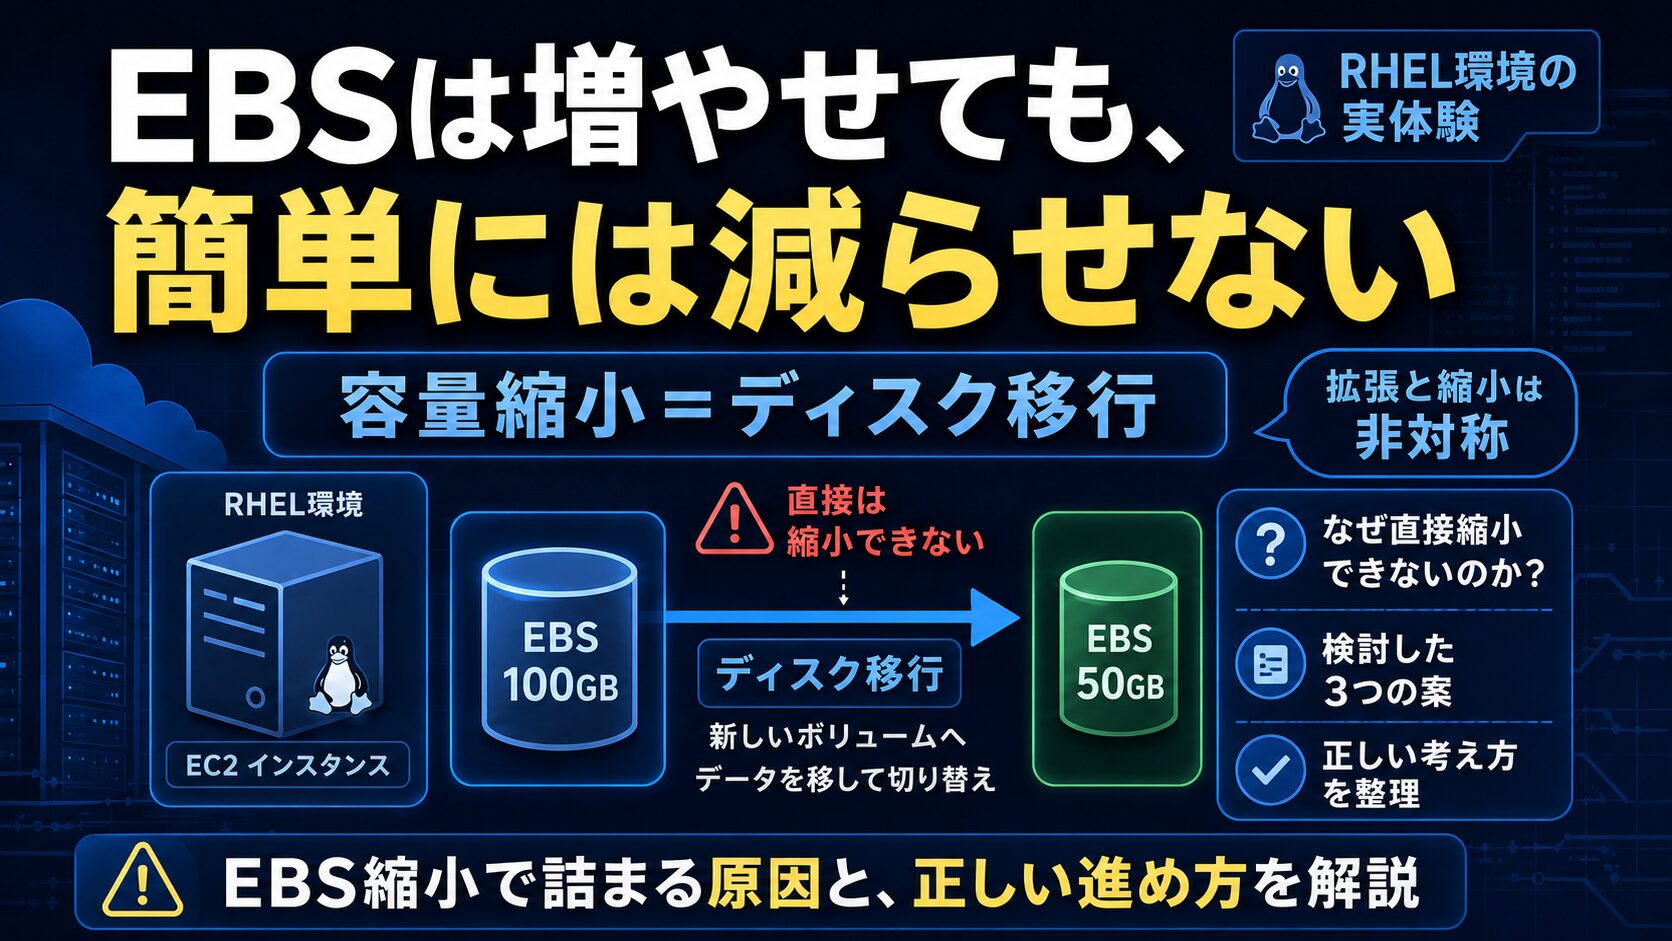
EBSは、容量を増やすのは比較的簡単です。
しかし、同じ感覚で「小さくできる」と考えると、実務では詰まります。
今回扱うのは、Red Hat Enterprise Linuxを利用しているEC2で、EBSの容量縮小を検討したときの話です。
容量拡張であれば、AWS側でEBSボリュームサイズを拡張し、OS側でパーティションやファイルシステムを拡張することで対応できます。
一方で、容量縮小は同じ考え方では進みません。
なぜなら、EBSの容量縮小は、既存ディスクのサイズを小さくする作業ではないからです。
実態としては、小容量ディスクを新しく作り、必要なデータを移して切り替える作業です。
つまり、容量縮小に見えても、考えるべきことはディスク移行です。
今回は、EBS縮小にあたって検討した3つの案と、最終的にどのような考え方で対応したのかを整理します。
そもそも、なぜ認識がズレるのか
まず最初に確認しておきたいのは、「縮小しようとしたこと」自体が悪いわけではない、ということです。
コスト削減や容量適正化の観点から、過剰に確保されたディスク容量を見直すことは当然あります。
問題は、容量縮小を「単なるサイズ変更」と捉えてしまうことです。
クラウドストレージは柔軟に見えます。
実際、EBSの拡張は比較的やりやすいです。
AWS側でボリュームサイズを拡張し、OS側でその拡張分を認識させれば、既存の領域を広げることができます。
しかし、縮小は違います。
AWSのEBSにおいて、拡張と縮小は非対称です。
-
拡張方向:既存のボリュームを大きくできる
-
縮小方向:既存のボリュームをそのまま小さくする操作はできない
ここを誤解すると、設計や作業計画の段階でズレます。
「クラウドだから柔軟に変えられる」
この感覚は、拡張方向にはある程度当てはまります。
しかし、縮小方向にはそのまま当てはまりません。
この非対称性を理解していなかったことが、今回のつまずきの根本でした。
容量拡張は比較的素直にできる
EBSの容量拡張であれば、作業の考え方は比較的明確です。
RHEL環境であれば、流れはおおむね次のようになります。
-
AWS側で既存EBSボリュームのサイズを拡張する
-
Linux OS上でパーティションを拡張する
-
必要に応じてLVM側の設定を拡張する
-
ファイルシステムを拡張する
この流れを図にすると、以下のようになります。

容量拡張は、既存の構成を保ったまま、ディスク領域を順番に広げていく作業です。
EBSを拡張し、OS側でパーティションやLVM、ファイルシステムに反映していく。
つまり、拡張は「今ある領域を広げる」作業として整理できます。
もちろん、実務では事前バックアップを取得したうえで作業します。
それでも、容量拡張は「既存構成を壊さずに広げる」方向の作業として成立しやすいです。
しかし縮小は、同じ考え方ではできない
問題は、容量縮小です。
容量縮小も、拡張と同じ感覚で考えたくなります。
「AWS側でサイズを小さくして、OS側でも縮小すればよい」
一見、自然に見えます。
しかし、これはできません。
EBSは、既存ボリュームを直接縮小する操作を提供していません。
つまり、容量縮小は「既存ディスクを小さく加工する」作業ではないのです。
実務上の考え方は、こうなります。
縮小するのではなく、小容量EBSを新しく作り、必要なデータだけを移す。
これはディスク縮小ではありません。
小容量ディスクへの移行です。
この発想の切り替えが必要です。
また、OSのファイルシステムとしてXFSを使用している場合、ファイルシステム自体を縮小することはできません。
そのため、バックアップ、ファイルシステムの再作成、リストアという流れで考える必要があります。
ここで必要なのは、縮小コマンドを探すことではありません。
「これは移行作業である」と捉え直すことです。
拡張と縮小の違いを、あえてシンプルに図にするとこうなります。

ポイントは、縮小が「既存ディスクを小さくする作業」ではないことです。
小容量EBSを新しく作り、必要なデータを移し、切り替える。
この時点で、容量縮小はサイズ変更ではなく、移行作業として考える必要があります。
検討した3つの案
今回、実際に検討した案は次の3つです。
案1:既存EBSを直接縮小する
結論:不可
EBSボリューム自体を直接縮小することはできません。
無理に考えると、OS上のパーティションやファイルシステムとの整合性が崩れ、データ破損につながるリスクがあります。
案2:AMIから小容量EBSへ復元する
結論:今回は不可
AMIからの復元そのものが悪いわけではありません。
しかし、元ディスクの構成を、そのまま小容量EBSへ復元する前提では整合性が取れません。
EBSは、元のボリュームより小さいサイズへ単純に戻すことはできません。
また、OS領域、パーティション構成、LVM、ファイルシステムの状態を踏まえずに小容量EBSへ戻そうとすると、容量不足や構成不整合が発生します。
特にXFSのように縮小できないファイルシステムを使っている場合、LVMだけを見て小さくできるとは判断できません。
そのため、今回の対策としては採用できませんでした。
案3:OS上でバックアップ・リストアする
結論:採用
小容量EBSを新規作成し、OS上でデータを退避・復元する方法です。
ただし、OS上の使用容量が、縮小後のEBS容量より小さいことが前提です。
つまり、EBSを直接縮小するのではなく、小容量ディスクへ必要なデータを移す、という考え方です。
文章だけだと少し分かりにくいので、3つの案をイメージで並べると以下のようになります。

案1は、既存EBSを直接小さくしようとする考え方です。
案2は、AMIから小容量EBSへ戻そうとする考え方です。
案3は、小容量EBSを新規作成し、必要なデータを移す考え方です。
今回採用したのは、案3でした。
ここからは、それぞれの案で何が問題だったのかを見ていきます。
案1:既存EBSをそのまま縮小する
最初に考えたのは、既存EBSを直接小さくできないか、という案です。
容量拡張の逆で、既存ボリュームのサイズを小さい値に変更できないか、という発想です。
しかし、これは採用できませんでした。
理由は単純です。
EBSには、既存ボリュームを直接縮小する操作がないためです。
容量拡張はできます。
しかし、容量縮小はできません。
ここで重要なのは、EBSのサイズだけを見てはいけないということです。
EC2から見れば、EBSはディスクです。
その上にはパーティションがあり、場合によってはLVMがあり、その上にファイルシステムがあります。
仮にディスクの外側だけを小さくできたとしても、OS上のパーティションやファイルシステムとの整合性が崩れれば、データ破損につながります。
つまり、既存EBSをそのまま小さくするという発想自体が危険です。
案2:AMIから小容量EBSへ復元する
次に考えたのは、既存インスタンスからAMIを取得し、小容量EBS構成で復元する案です。
バックアップから新しい環境を作り直すだけなので、一見うまくいきそうに見えます。
しかし、これも今回の条件では採用できませんでした。
問題は、元ディスクの構成と、復元先ディスクの容量の整合性です。
AMIから復元する場合、元のブロックデバイス構成、パーティション構成、ファイルシステムの状態が前提になります。
その構成を、元より小容量EBSへそのまま復元しようとすると、容量不足や構成不整合が発生します。
ここで誤解してはいけないのは、「AMIが使えない」という話ではないことです。
AMIはバックアップや環境複製の手段として有効です。
ただし、今回のように「元より小容量ディスクへそのまま戻す」前提では、単純には成立しません。
OS領域、パーティション構成、LVM構成、ファイルシステムの状態を踏まえずに、
「AMIを取って、小容量EBSで戻せばよい」
と考えるのは危険です。
案3:OS上でバックアップ・リストアする
最終的に採用したのは、Linux OS上でデータをバックアップし、小容量EBSを新規作成して、そこへリストアする方法です。
ここで重要なのは、EBSを縮小しているわけではない、ということです。
小容量EBSを新しく作る。
そこに必要なデータを戻す。
つまり、これはディスク縮小ではなく、ディスク移行です。
ただし、この方法にも重要な前提があります。
OS上の使用容量が、縮小後のEBS容量よりも小さいこと。
これが満たされない場合、この方法も採用できません。
たとえば、100GBのEBSを50GBにしたい場合、実際にOS上で使用している容量が50GBを超えていれば、当然ながら移行先に入りません。
「EBSの見かけ上の容量」ではなく、「実際に使用している容量」を確認する必要があります。
XFSを利用している環境では、ファイルシステム単位のバックアップ・リストアとして、`xfsdump` / `xfsrestore`を使う方法があります。
単純なファイルコピーではなく、ファイルシステムの属性や構造を踏まえて退避・復元したい場合に検討する方法です。
ただし、実際に採用するバックアップ方式は、対象がOS領域なのか、データ領域なのか、停止可能時間、整合性要件、アプリケーション要件によって変わります。
「XFSなら必ずこの方法」という話ではありません。
あくまで、今回の条件において選択した方法です。
作業の全体像は、以下のようになります。
-
Linux OS上でデータをバックアップする
-
小容量EBSを新規作成する
-
Linux OS上でパーティションを設定する
-
必要に応じてLVMを設定する
-
ファイルシステムを作成する
-
バックアップデータをリストアする
-
マウント設定やサービス起動を確認する
-
アプリケーションの動作確認を行う
ここで大事なのは、バックアップして戻せば終わりではない、ということです。
特に注意したいのが、UUIDとマウント設定です。
小容量EBSを新規作成すると、既存EBSとは別のディスクになります。
そのため、ファイルシステムのUUIDが変わる場合があります。
`/etc/fstab` でUUIDで指定している場合、移行後のUUIDと設定が一致していないと、OS起動時にマウントできない、起動が遅延する、あるいは起動時にエラーになることがあります。
また、マウントできたとしても、それだけで作業完了とは言えません。
アプリケーションの起動、ログ出力先、ジョブの出力先、監視・バックアップ対象などは、環境によって確認観点が変わります。
そのため、単に「リストアできたか」ではなく、自社の運用定義に合わせて確認観点を整理しておく必要があります。
今回、何が甘かったのか
今回の反省点は、単に「EBS縮小の手順を知らなかった」ことではありません。
もっと根本的には、容量縮小という作業の捉え方が甘かったことです。
甘かった点①:削減作業を、移行作業として計画していなかった
これが一番大きいです。
容量縮小は、見た目にはコスト削減作業です。
不要に大きく確保されたディスク容量を見直し、適正なサイズにする。
そう考えると、単なる設定変更やリソース変更のように見えます。
しかし実態は違います。
容量縮小は、小容量ディスクへの移行作業です。
移行作業として捉えていれば、最初から次の観点を計画に入れます。
-
どのデータを退避するのか
-
どの方式でバックアップするのか
-
どれくらい停止時間が必要なのか
-
復元後に何を確認するのか
-
失敗した場合、どう切り戻すのか
-
アプリケーションや運用にどの影響があるのか
しかし、「縮小作業」とだけ捉えていると、これらの検討が後回しになります。
そして作業直前になって、
「どうやって戻すのか」
「切戻しはどうするのか」
「業務影響はどこまであるのか」
という話になります。
これは、かなり危険です。
容量縮小は、削減作業である前に移行作業です。
ここを間違えると、作業計画そのものが甘くなります。
甘かった点②:EBSは増やせるから減らせる、と思い込んでいた
次に甘かったのは、拡張と縮小を同じ種類の作業だと考えていたことです。
クラウドのストレージは柔軟に見えます。
しかし、柔軟なのは主に拡張方向です。
容量を増やす場合は、既存領域を広げる方向の作業になります。
一方で、容量を減らす場合は、既存領域を削るのではありません。
小さい領域を新しく作り、必要なデータを移す作業になります。
この違いを理解していないと、
「AWS側でサイズを小さくできないのか」
「OS側でファイルシステムを縮められないのか」
「AMIで戻せばよいのではないか」
という発想になります。
しかし、実務で必要なのは、縮小操作を探すことではありません。
移行方式を設計することです。
甘かった点③:OS・パーティション・ファイルシステムの関係を軽く見ていた
EBSの容量を変える作業は、AWS側だけでは完結しません。
EC2から見れば、EBSはディスクです。
その上にはパーティションがあります。
場合によってはLVMがあります。
その上にファイルシステムがあります。
そして、そのファイルシステム上にOSやアプリケーションのデータがあります。
この階層を意識せずに作業すると、どこを変更しているのか分からなくなります。
EBSを変更しているのか。
パーティションを変更しているのか。
LVMを変更しているのか。
ファイルシステムを変更しているのか。
マウント設定を変更しているのか。
ここを曖昧にしたまま進めると、OSが起動しない、マウントできない、データが読めない、といった事故につながります。
クラウドを使っていても、OSとファイルシステムの基本は消えません。
むしろ、AWS側の操作とOS側の構造をつなげて理解していないと、簡単そうな作業ほど危険になります。
手順の前に、作業の性質を見極める
この話は、EBSだけの話ではありません。
クラウドサービスを使っていると、リソース変更が簡単に見えることがあります。
-
CPUを増やす
-
メモリを増やす
-
ディスクを増やす
-
インスタンスタイプを変える
-
スナップショットを取る
コンソール上では、確かに操作できます。
しかし、システムとして安全に変更できるかは別です。
今回の自分の反省も、まさにそこにありました。
最初は、容量縮小を「ディスクサイズを小さくする作業」として見ていました。
だから、まず探したくなるのは、縮小するための手順やコマンドです。
しかし実際には、これはサイズ変更ではなく、小容量ディスクへの移行作業でした。
この見立てが変わると、考えるべきことも変わります。
-
バックアップはどうするのか
-
リストアはどうするのか
-
停止時間はどれくらい必要なのか
-
失敗した場合、どう切り戻すのか
-
移行後に、OS・アプリケーション・運用の観点で何を確認するのか
作業の性質を見誤ると、手順をどれだけ調べても計画が甘くなります。
逆に、最初に「これは移行作業だ」と捉えられれば、必要な確認観点が見えてきます。
今回の学びは、EBS縮小の具体的な手順そのものではありません。
手順の前に、作業の性質を見極めること。
これが、クラウド環境の変更作業では特に重要だと感じました。
まとめ
EBSの容量縮小は、単なるサイズ変更ではありません。
拡張は、既存の領域を広げる作業です。
縮小は、新しい小容量ディスクへ移し替える作業です。
この2つは、同じ種類の作業ではありません。
この違いを理解していないと、作業直前になって次のような状態になります。
-
AWS側に縮小操作がない
-
AMIから戻せばよいと思ったが、容量が合わない
-
OS上でどう復元するか決めていない
-
UUIDやマウント設定の確認が漏れている
-
切戻し方針を用意していない
-
動作確認の観点が整理されていない
クラウドだから簡単、ではありません。
クラウドを使うほど、インフラの基本が不要になるわけでもありません。
むしろ、AWSの仕様とOSの構造をつなげて理解していないと、簡単そうに見える作業ほど危険になります。
EBSの容量縮小で必要なのは、縮小コマンドを探すことではありません。
「これはディスク移行作業である」と捉え直すことです。
このあたりは、以下の記事でも詳しく書いています。
【前編】詳細設計で決めること|基本設計を「構築・テスト・運用できる形」に落とし込む工程
シリーズ全体は「実務で使えるシステム開発方法論」マガジンにまとめています。
コメント