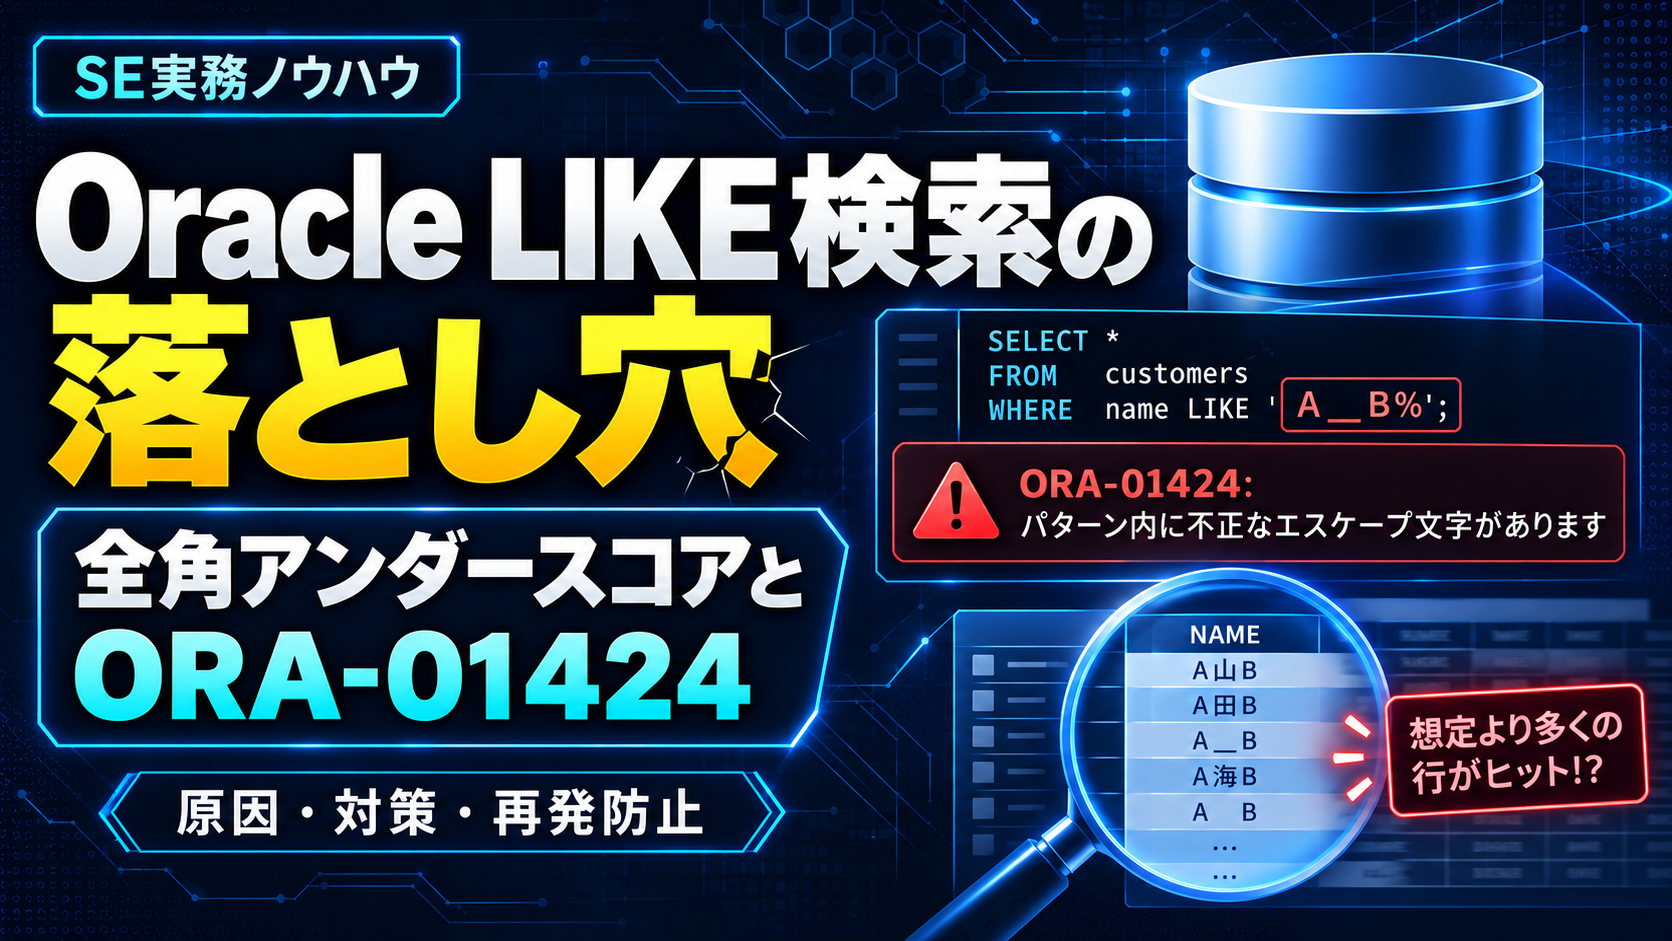
データベースの検索結果が想定より多いとき、SQLの書き方だけを疑っていないでしょうか。検索条件が正しく見えても、データ型や文字セット、データベースのリリースによって文字の解釈が変わることがあります。
ある処理で、全角アンダースコア「_」を含むデータを探したところ、意図しない大量のレコードが検索対象になる事象が発生しました。調査では、公開されていたサポート情報と実機の動作が食い違い、最終的にOracle側の不具合と確認されました。しかし、製品側に修正があるからといって、パッチ適用がプロジェクトの最適解とは限りません。
本記事では、事象の把握→原因の切り分け→対策の比較→実施→効果確認→再発防止の過程を紹介します。あわせて、Oracle Database 19cの公式仕様に基づく現在の書き方と、読者自身が確認するための検証SQLを示します。
先に結論:Oracle 19cでのLIKE検索
- ワイルドカードは半角の
%(0文字以上)と_(1文字)。全角の%と_は通常の文字として扱うのが公式仕様です。- 利用者が入力した半角
%・_を文字として探すときは、ESCAPE句で明示的にエスケープします。バインド変数だけではワイルドカード化を防げません。- 過去の案件で採用した
LIKECへの一律変更は、19cでの一般的な推奨規約ではありません。照合順序・データ型も含めて、実際に使用するDB環境で検証して判断します。※障害事例は特定リリースの記録ですが、Oracle 19cの説明・SQL例は公式仕様に基づいており、筆者は19c実機での再現・効果検証を実施していません。利用するリリース、文字セット、データ型、照合順序で読者自身が検証してください。
1. 事象発生:全角アンダースコアの検索で想定外の大量ヒット
何を検索したかったのか
アプリケーションでは、データに含まれる全角アンダースコア「_」を、文字そのものとして検索したいという要件がありました。ところが、問題が発生したOracle Database 11.2.0.1環境では、次のような検索が想定外の結果になりました。
-- 過去の障害を説明するために匿名化したSQL
-- 両端の % は半角、中央の _ は全角
SELECT *
FROM TEST
WHERE EFG LIKE '%_%';
検索条件のつもりは「全角の_を含む行」です。しかし、当該環境では条件内の全角_がワイルドカードのように機能するケースがありました。もし'%_%'の_が「任意の1文字」と解釈されれば、左右の%は0文字でもよいため、NULLでない1文字以上の値の多くが条件に一致します。「全件ヒット」と呼びたくなる結果が生じた理由はここにあります。
第一の問題は検索結果の正しさです。「全角_を含む行だけ」という要件に対し、含まない行まで一致してしまいました。さらに検索対象の拡大は、不要な行の読み込みや検索処理の負荷増大にもつながります。本案件は実際に性能問題として調査対象となりましたが、問題を理解するうえでは、まず検索結果そのものが誤る点を押さえる必要があります。
半角・全角の違いは目視では分かりにくい
| 文字 | 表示 | 本来の役割(19cの標準仕様) |
|---|---|---|
| 半角パーセント | % | 0文字以上に一致するワイルドカード |
| 半角アンダースコア | _ | ちょうど1文字に一致するワイルドカード |
| 全角パーセント | % | 通常の文字 |
| 全角アンダースコア | _ | 通常の文字 |
SQLのレビュー画面では、特に半角_と全角_を見落としやすくなります。また、問題の本質は「全角文字が常にワイルドカードになる」ことではありません。過去の検証記録では、パターンに半角の%や_が混在したとき、全角%・_がワイルドカードとして動作する現象が問題となりました。
2. 現状把握・原因調査:仕様、データ型、実機結果を突き合わせる
まず再現条件を小さくする
障害対応では、いきなり本番SQLを広範囲に修正するのではなく、現象を小さな表と短いSQLで再現します。この案件でも、CHAR、NCHAR、NVARCHAR2、VARCHAR2を使い、半角・全角のアンダースコアを格納したテストデータで挙動を確認しました。
調査の観点は、次の4つに分けられます。
| 確認項目 | 確認の目的 | 具体例 |
|---|---|---|
| 検索文字 | 半角・全角の混同がないか | %と%、_と_を区別 |
| データ型 | 列と検索パターンの変換があるか | VARCHAR2、NVARCHAR2など |
| 文字セット | 各国語キャラクタセットの条件 | NLS_NCHAR_CHARACTERSETを確認 |
| SQLの種類 | 比較方式とESCAPEの影響 | LIKEとLIKECを比較 |
各国語キャラクタセットは、例えば次のSQLで確認できます。
SELECT parameter, value
FROM NLS_DATABASE_PARAMETERS
WHERE parameter IN ('NLS_CHARACTERSET', 'NLS_NCHAR_CHARACTERSET');
過去のサポート調査では、各国語キャラクタセットが固定幅かどうかも論点になりました。再現性を評価するときは、実際の環境で確認した文字セット名と、対象列の型を記録します。
サポート文書と実測結果が一致しなかった
当時のサポート情報には、特定のNCHAR・NVARCHAR2環境では、全角の%をワイルドカードとして扱わないという説明がありました。しかし、検証環境では半角記号との組合せなどにより、説明と一致しない結果が得られました。
サポート窓口への初期問い合わせでは、特定リリースの「仕様」とする説明が提示されました。しかし、当時のサポート文書では全角記号をワイルドカードとして扱わないと説明されている一方、手元の実機では半角記号が混じると一致範囲が広がりました。私は、仕様の説明だけでは今回のSQL実行結果を説明できないと考えました。 そこでSQL、データ型、再現条件、エラーを具体的に提示し、継続調査を依頼しました。その後、Oracle側から製品の不具合に起因する事象と考えられるとの回答があり、11.2.0.4で修正済みと報告されました。
ここで重要なのは「メーカーの回答を疑う」という姿勢ではありません。文書の記述と実測が異なる場合に、同じ条件で再現できる証拠をそろえ、技術的な説明がつくまで調べることです。技術的な事実を確定させると、対策を比較する土台ができます。
3. 対策の立案・評価:ORA-01424と将来互換性まで比較する
対策を「直せるか」ではなく「全体コスト」で比べる
原因が製品不具合だと分かると、パッチ適用が第一候補に見えます。しかし、稼働中システムのパッチ適用では、問題の検索処理以外の業務機能にも影響しないかを確認する必要があります。今回の案件では、パッチの適用作業そのものより、広範囲の影響調査・回帰テスト・リリース調整にかかる工数が大きいと評価しました。
複数の業務グループを集めてアクション会議を開催し、方式・基盤側が技術評価・再現検証を主導、業務側には影響範囲と運用上の回避可否の確認を依頼しました。GLとして、技術的な正しさに加え、PMと業務側が費用・リスク・運用制約を含めて選択できるよう整理したのです。
| 対策候補 | 長所 | 案件での評価・採用範囲 |
|---|---|---|
| A. パッチセット適用 | 製品不具合そのものの修正が期待できる | DB全体の影響調査・回帰テストが大きい。今回の障害対応を目的とする適用は見送る |
B. LIKE+全角記号のESCAPE | 一見、修正量を限定できる | 11.2.0.1の再現SQLですでにORA-01424。有効な回避策にならない |
C. LIKECへの変更とエスケープ方式の整理 | 旧環境ではLIKEC+全角エスケープが動作し、保守サポートもSQL書き換えを回避策として提示。原因と対策候補について技術的な認識をそろえられた | 新規・改修SQLの記述方針として採用。将来の修正済みリリースで問題になる全角エスケープは規約で禁止。既存処理の残存リスクには運用回避を併用 |
| D. 運用回避 | 大量の既存SQL改修を避け、限定的な対象データ・業務だけで対応できる | 改修工数が大きく、対象データが少ない既存機能で採用。回避手順と影響範囲を業務側と共有し、SQL規約と組み合わせて案件として対応 |
これは特定案件での費用・リスク評価です。パッチにセキュリティ修正が含まれる場合、サポート要件がある場合などは、別の結論になることがあります。
ORA-01424を生んだのはどの書き方か
実機確認で明らかになったのは、「全角記号をエスケープする」という方針自体が、リリースの違いによって成立しなくなることでした。
-- 旧リリース(11.2.0.1)では ORA-01424 を確認
SELECT * FROM TEST WHERE EFG LIKE '%\_%' ESCAPE '\';

-- 同じ旧リリースで実行できた、LIKEC+全角エスケープ
SELECT * FROM TEST WHERE EFG LIKEC '%\_%' ESCAPE '\';

-- ただし上のLIKEC文は11.2.0.4の検証環境では ORA-01424
| SQL方式・パターン | 11.2.0.1での記録 | 11.2.0.4での記録・仕様 | 判断 |
|---|---|---|---|
LIKE '%\_%' ESCAPE '\' | ORA-01424 | 全角記号はリテラルとなり、同じエスケープは無効 | 旧環境の対策にはできない |
LIKEC '%\_%' ESCAPE '\' | 実行できた | ORA-01424を実機確認 | 将来互換性がない |
LIKEC '%_%'(全角をエスケープしない) | 半角・全角が混在する旧環境の検索条件では、SQL記述の統一だけでリスクをなくせない | 全角_を通常文字として扱う仕様 | 新規・改修SQLの規約として採用。旧環境で影響を受ける既存処理は運用回避と組み合わせ、案件の対応目的を達成 |
LIKE '%_%'(全角をエスケープしない) | 半角%との組合せで想定外にヒット | 全角_を通常文字として扱う仕様 | 修正済みリリースでは基本形 |
ORA-01424が発生するのは、ESCAPE '\'に指定したエスケープ文字の次に、リテラル化の対象となる半角%・_やエスケープ文字自身ではなく、通常文字である全角_が続くためです。修正前に成立した「全角記号のエスケープ」が、修正後には無効な指定になることを理解する必要があります。
対策を採用する前に、修正対象の現行環境だけでなく、将来のアップグレード先でも同じSQLが成立するかを確認したことが、二度の改修を避けるうえで重要でした。
なぜLIKECをSQL規約として採用したのか――保守サポートと技術的な認識をそろえる
今回重視したのは、LIKEとLIKECのどちらが一般的に優れているかではありません。調査では、旧環境のNCHAR・NVARCHAR2列に対し、LIKEに全角エスケープを付けるとORA-01424になる一方、LIKECなら実行できる組合せを確認しました。保守サポートからもLIKECへの書き換えが回避策として提示され、原因、成立する回避方法、リリースによる挙動の違いについて、サポートと技術的な認識をそろえることができました。
ただし、将来のアップグレード後には、全角記号をエスケープしたLIKECがORA-01424になることも実機で確認しました。そこでプロジェクトのSQL規約では、「パターンマッチングにはLIKECを使い、半角%・_を文字として探す場合にエスケープする。全角%・_はエスケープしない」という方針を定めました。
この規約は、旧環境に存在した全角記号の問題をすべてSQLだけで解消するという意味ではありません。今回の対応目的を、新規・改修SQLの記述を統一すること、影響のある既存機能のリスクを抑えながら業務を継続すること、将来のアップグレード時に同じ箇所を再改修しないことと定め、改修量が大きい一方で対象データが限定的な部分には運用回避を併用しました。
この対策で目的を達成できることについて、保守サポートから得た技術的根拠を持ち、PMや業務側に説明して実施方針の合意につなげられたことが重要です。 自分たちの推測だけではなく、問い合わせ結果と実機検証に基づいて判断したことは、後から対応理由を説明する際にも役立ちます。保守サポートが確認したのは製品動作と回避策に関する技術的見解であり、改修・運用回避の適用範囲や工数の判断はプロジェクト側の責任で決めました。
今回パッチを見送り、SQL規約と運用回避を選んだ理由
今回の障害への個別対処としてパッチを当てることは選択しませんでした。製品修正を適用すれば問題箇所は直っても、影響調査を対象SQLだけで済ませられず、調査・試験の総コストが大きかったためです。
一方、SQL修正であれば対象機能を絞って検証できます。ただし、既存SQLの改修箇所が膨大なのに、問題となるデータや利用場面が少ない場合は、改修・試験の工数が効果に見合いません。そこで影響の大きさと対象データの量、運用で吸収できる負担を比較し、必要なSQL修正と運用回避を使い分ける方針を選びました。新規・改修SQLにはLIKECの規約を適用し、既存機能のうち費用対効果が見合わない範囲は運用面で対処します。
4. 対策の実施:変更範囲を絞り、SQL規約と運用を整える
改修対象と運用対象を分けて展開する
SQL規約を改訂し、パターンマッチングにはLIKECを利用すること、半角の%と_をリテラルとして検索するときはエスケープすること、全角の%と_にはエスケープを付けないことを定めました。新規・改修SQLではこの方針を使い、既存機能については改修の費用対効果と業務影響を見て対応方法を選びました。
SQL改修が膨大でも、対象データが限られ、現場で無理なく回避できるなら、運用対応の方が合理的な場合があります。運用回避を選んだ機能については、対象条件と対処手順を業務側に周知する必要があります。
GLの役割は、技術評価と業務上の判断をつなぐこと
今回、複数の業務グループを集めたアクション会議で、影響調査と対応の方向性を整理しました。方式・基盤側がSQLの再現検証と対策評価を主導し、業務側には対象機能や対象データ、運用回避の可否を確認してもらいました。
PMへの説明では、パッチ適用の作業費だけでなく、DB全体の影響調査・回帰テスト・変更管理の総コストと、SQL改修後の将来互換性を比較しました。さらに、保守サポートに確認した技術的な内容を対策の根拠として示し、業務側とは修正する範囲と運用回避する範囲を調整しました。技術的に可能な対策と、プロジェクトとして選ぶべき対策は必ずしも同じではありません。 GLには、製品側の技術的見解を確認するだけでなく、PM・業務側の合意形成を通じて実行可能な対策へ落とし込む役割があります。
今回のように、データベースで発生した問題が必ずしもDB側の設定だけで解決するとは限りません。SQLの実装や業務要件にも踏み込み、アプリケーション担当者や保守サポートと連携して原因を切り分けることも、DBAの重要な仕事です。
DBAが担う物理設計、性能管理、障害対応、バックアップ・復旧などの役割については、次の記事で詳しく解説しています。
5. 効果の確認:検索結果の正しさと将来互換性を確認する
SQLの実行可否・検索結果・将来互換性を確認する
SQLの検証では、エラーが出ないだけでは合格にできません。「全角_を含む行だけを返す」という要件を満たすか、含まない行が混ざらないかまで確認します。さらに、同じ検索処理が将来のアップグレード後にも成立するかを調べます。
| 検証観点 | 確認内容 |
|---|---|
| 事象の再現 | 旧リリースのLIKE '%_%'で、全角_を含まない値も検索対象となる |
| SQLの実行可否 | LIKE '%\_%' ESCAPE '\'では旧環境でORA-01424、LIKEC '%\_%' ESCAPE '\'では旧環境で実行可能 |
| 将来互換性 | 修正済みリリースではLIKEC+全角エスケープがORA-01424となる |
| 文字の組み合わせ | 全角_・%と半角_・%を混在させ、意図しない一致がないか確認する |
| 列型と環境条件 | VARCHAR2・NVARCHAR2、文字セット、照合順序を記録する |
| 運用回避の成立 | 改修しない部分について、対象データと回避手順が実際の業務で扱えるかを確認する |
| 性能への影響 | ヒット件数、実行計画、I/O、応答時間を確認する |
実行できるSQLと、業務要件どおりの結果を返すSQLは別です。 この区別が、原因調査でも、対策評価でも重要でした。
次章以降の規約・テスト項目に反映する際は、全角と半角を混ぜた入力、エスケープ文字、NULLや空文字なども含め、同じ不具合を再び見落とさないようにします。現行Oracle向けの具体的なSQL例は第7章で紹介します。
6. 歯止め:個別対処をプロジェクト全体のルールにする
SQL規約に判断結果を反映する
実案件では、SQL規約に「パターンマッチングにおけるLIKECの利用」を新設し、設計・コーディング時の確認基準としてプロジェクトに展開しました。
重要なのは、調査担当者だけが知っている注意点を、ほかの開発メンバーも実践できるルールに変えたことです。規約、レビュー観点、テストデータまで揃えてこそ、障害対応が再発防止につながります。
当時の規約改訂は、その案件の環境と将来のリリース変更を考慮したものです。現在のOracle 19c向けの規約としては、そのままコピーせず、次節に示すようにLIKEを原則としたうえで、必要な例外条件を整理します。
再発防止は「注意喚起」で終わらせない
プロジェクト内へ周知するだけでなく、SQLレビューで確認する項目と、テストで使う文字の組合せを具体化します。例えば、検索条件に利用者入力が含まれる処理では、半角%・_・エスケープ文字、全角%・_、NULLや空文字をテストデータに含めます。
修正箇所だけでなく、SQLの作り方とレビュー観点を変えることが歯止めになります。既存の機能が大きく、全面改修が現実的でない場合には、運用制約を明示し、将来の改修時に見直す対象として管理することも必要です。
7. Oracle 19cではどう書くか:LIKE・ESCAPE・照合順序
Oracle 19cの公式仕様では全角は通常の文字
Oracle Database 19cのSQL言語リファレンスでは、LIKEのワイルドカードとして認識するのはASCII相当の半角%と_で、全角の%と_は通常の文字として扱うと説明されています。また、Oracleはほとんどの場合にLIKEを推奨し、LIKECはUnicodeの完全な文字単位で比較する必要がある場合の選択肢と位置付けています。
そのため、19cで旧案件のSQL規約をそのまま移植し、すべてのLIKEをLIKECへ変更する必要はありません。適切な演算子は検索要件に基づいて選択します。
| 検索要件 | SQLの考え方 |
|---|---|
全角_を含む値を探す | 原則としてLIKE '%_%' |
半角_を文字として探す | LIKE '%\_%' ESCAPE '\' |
半角%を文字として探す | LIKE '%\%%' ESCAPE '\' |
| 利用者入力を部分一致検索する | 入力中の\・%・_をエスケープし、バインド変数で渡す |
| Unicodeの複合文字を1文字として評価する | 要件に応じてLIKECを検討 |
適用時は列のデータ型・照合順序・入力値の取り扱いを確認します。
入力値のワイルドカードはバインド変数だけでは防げない
現行システムで起こりやすいのは、検索欄に利用者が入力した%や_がそのままワイルドカードとして解釈され、想定より広い範囲に一致してしまう問題です。
例えば次のSQLは、SQLインジェクションを防ぐ目的でバインド変数を使用していても、:keyword中のワイルドカードが有効なままです。
-- バインド変数を使っていても、入力中の % や _ はワイルドカードとして働く
SELECT *
FROM TEST
WHERE EFG LIKE '%' || :keyword || '%';
利用者入力を通常の文字列として部分一致検索したい場合は、先にエスケープ文字自体を二重化し、その後%と_をエスケープします。次は説明用のSQLです。
-- :keyword を1か所でバインドするSQL例
-- 未入力はNULLとして扱い、検索対象としない
WITH input_keyword AS (
    SELECT :keyword AS keyword FROM dual
)
SELECT t.*
FROM TEST t
CROSS JOIN input_keyword k
WHERE k.keyword IS NOT NULL
  AND t.EFG LIKE
      '%' ||
      REPLACE(
        REPLACE(
          REPLACE(k.keyword, '\', '\\'),
          '%', '\%'
        ),
        '_', '\_'
      ) || '%'
      ESCAPE '\';
REPLACEは、エスケープ文字→%→_の順序で適用します。逆順にすると、新たに挿入したエスケープ文字が再度処理され、意図しない検索パターンになる可能性があります。
Oracleは空文字列をNULLとして扱うため、未入力を検出する条件としてLENGTH(:keyword) > 0を追加する必要はありません。未入力で全件表示する仕様の場合は別途分岐してください。また、上の例ではバインド変数はSQL中の1か所です。実運用ではアプリケーション側で文字列をエスケープしてから単一のバインド変数として渡す方法も選べます。
データ型がNVARCHAR2の場合は、文字列リテラルとバインド値の型変換も検証してください。また、検索語にSQL構文を連結するのではなく、値をバインドして渡す方針は維持します。
実機で確認するSQL:VARCHAR2とNVARCHAR2を比較
以下は読者のOracle 19c環境で試せる検証手順です。テスト専用スキーマで作成し、DBの文字セット・セッション設定も記録してください。全角・半角の字形が入力時に変換されていないかにも注意します。
-- 検証用テーブル(業務データは使用しない)
CREATE TABLE LIKE_TEST (
    ID NUMBER PRIMARY KEY,
    TXT_V VARCHAR2(40 CHAR),
    TXT_N NVARCHAR2(40)
);

INSERT INTO LIKE_TEST VALUES (1, '東京_本店', N'東京_本店');
INSERT INTO LIKE_TEST VALUES (2, '東京_本店',  N'東京_本店');
INSERT INTO LIKE_TEST VALUES (3, '東京%本店', N'東京%本店');
INSERT INTO LIKE_TEST VALUES (4, '東京%本店',  N'東京%本店');
INSERT INTO LIKE_TEST VALUES (5, '東京本店',   N'東京本店');
INSERT INTO LIKE_TEST VALUES (6, NULL, NULL);
COMMIT;

-- ① 全角_を含む値の検索:VARCHAR2/NVARCHAR2で比較
SELECT ID, TXT_V FROM LIKE_TEST WHERE TXT_V LIKE '%_%' ORDER BY ID;
SELECT ID, TXT_N FROM LIKE_TEST WHERE TXT_N LIKE N'%_%' ORDER BY ID;

-- ② 半角_はESCAPEを付け、文字として検索
SELECT ID, TXT_V FROM LIKE_TEST WHERE TXT_V LIKE '%\_%' ESCAPE '\' ORDER BY ID;
SELECT ID, TXT_N FROM LIKE_TEST WHERE TXT_N LIKE N'%\_%' ESCAPE '\' ORDER BY ID;

-- ③ 全角_にESCAPEを付けるとどうなるか(エラー確認用)
SELECT ID, TXT_V FROM LIKE_TEST WHERE TXT_V LIKE '%\_%' ESCAPE '\' ORDER BY ID;
SELECT ID, TXT_N FROM LIKE_TEST WHERE TXT_N LIKE N'%\_%' ESCAPE '\' ORDER BY ID;

-- ④ LIKECを使用した全角_の検索
SELECT ID, TXT_V FROM LIKE_TEST WHERE TXT_V LIKEC '%_%' ORDER BY ID;
SELECT ID, TXT_N FROM LIKE_TEST WHERE TXT_N LIKEC N'%_%' ORDER BY ID;

-- 確認終了後、必要な場合のみ実行
-- DROP TABLE LIKE_TEST PURGE;
公式仕様上、①と④では全角_を通常文字として扱い、②では半角_をエスケープし、③は無効なエスケープ指定となることが想定されます。実際の結果は照合順序・文字セットを含めて検証し、条件ごとの一致行・エラー番号を記録してください。必要に応じて、後述する照合順序の条件も記録してください。
照合順序によって文字の一致判定が変わる場合がある
Oracle 19cで全角_をワイルドカードとして扱わないことと、全角・半角の文字が比較上同じと見なされるかは別の問題です。LIKEの一致判定は、列・式の照合順序(collation)の影響を受けます。大文字・小文字、アクセント、文字幅など、区別したい属性がある場合は、対象DBの照合設定と実際の検索結果を確認してください。
-- セッションの比較設定を記録する
SELECT parameter, value
FROM NLS_SESSION_PARAMETERS
WHERE parameter IN ('NLS_COMP', 'NLS_SORT');
NLS_COMPやNLS_SORTに加え、列・式で指定された照合順序が評価に影響する場合もあります。検索結果の差を調査するときは、SQLだけでなく、これらの環境条件を合わせて記録することが重要です。
検索パターンの先頭に%を置く部分一致検索は、通常のB-tree索引の範囲検索を効率よく利用しにくくなります。大量データを対象にする場合は、実行計画やI/Oを確認し、必要に応じて検索方式・索引設計を見直します。
8. まとめ:サポートと根拠をそろえ、説明できる対策を選ぶ
今回の事例で重要だったのは、Oracleに不具合があったという事実だけではありません。検索結果の異常から出発し、再現条件を切り分け、サポート文書と実機の矛盾を根拠とともに提示して調査を依頼しました。
不具合を修正するパッチが存在しても、稼働中のシステムでは影響調査や回帰テスト、展開の負担まで含めて判断しなければなりません。今回の案件では、パッチ適用を見送り、新規・改修SQLの規約整備と、改修量に比べ対象データが少ない既存機能での運用回避を組み合わせる方針を選びました。さらに、旧環境で有効なエスケープ方式がアップグレード先ではORA-01424になることを検証し、将来の保守も考慮した規約としました。
こうした対策を選ぶうえで大きかったのは、保守サポートと技術的な認識をそろえ、その回答と実機検証を根拠にPM・業務側へ説明し、実施方針の合意を得られたことです。製品の動作についてはサポートに確認し、どの範囲を改修して何を運用で回避するかはプロジェクトで決める。その責任分界と判断根拠を明確にしたことで、対応を実行に移すことができました。
障害対応の本質は、技術的な解決策を見つけることだけではありません。品質・コスト・リスクを比較し、ベンダーと関係者の技術的な認識をそろえ、後から理由を説明できる対策を選ぶことです。 この進め方こそが、別の障害に直面したときにも再利用できる実務上のノウハウだと考えます。
なお、現在のOracle 19cでは、全角記号を通常文字として扱う仕様が明記されています。個々のシステムでは、利用者入力のワイルドカード化、文字セット、照合順序、性能面も含め、対象環境で検証して最終判断してください。
参考資料
- Oracle Database 19c SQL言語リファレンス:Pattern-matching Conditions — LIKE、LIKEC、ESCAPE、全角記号の扱い
- Oracle Database 19c Globalization Support Guide:Linguistic Sorting and Matching — NLS_COMP、NLS_SORT、照合順序
コメント