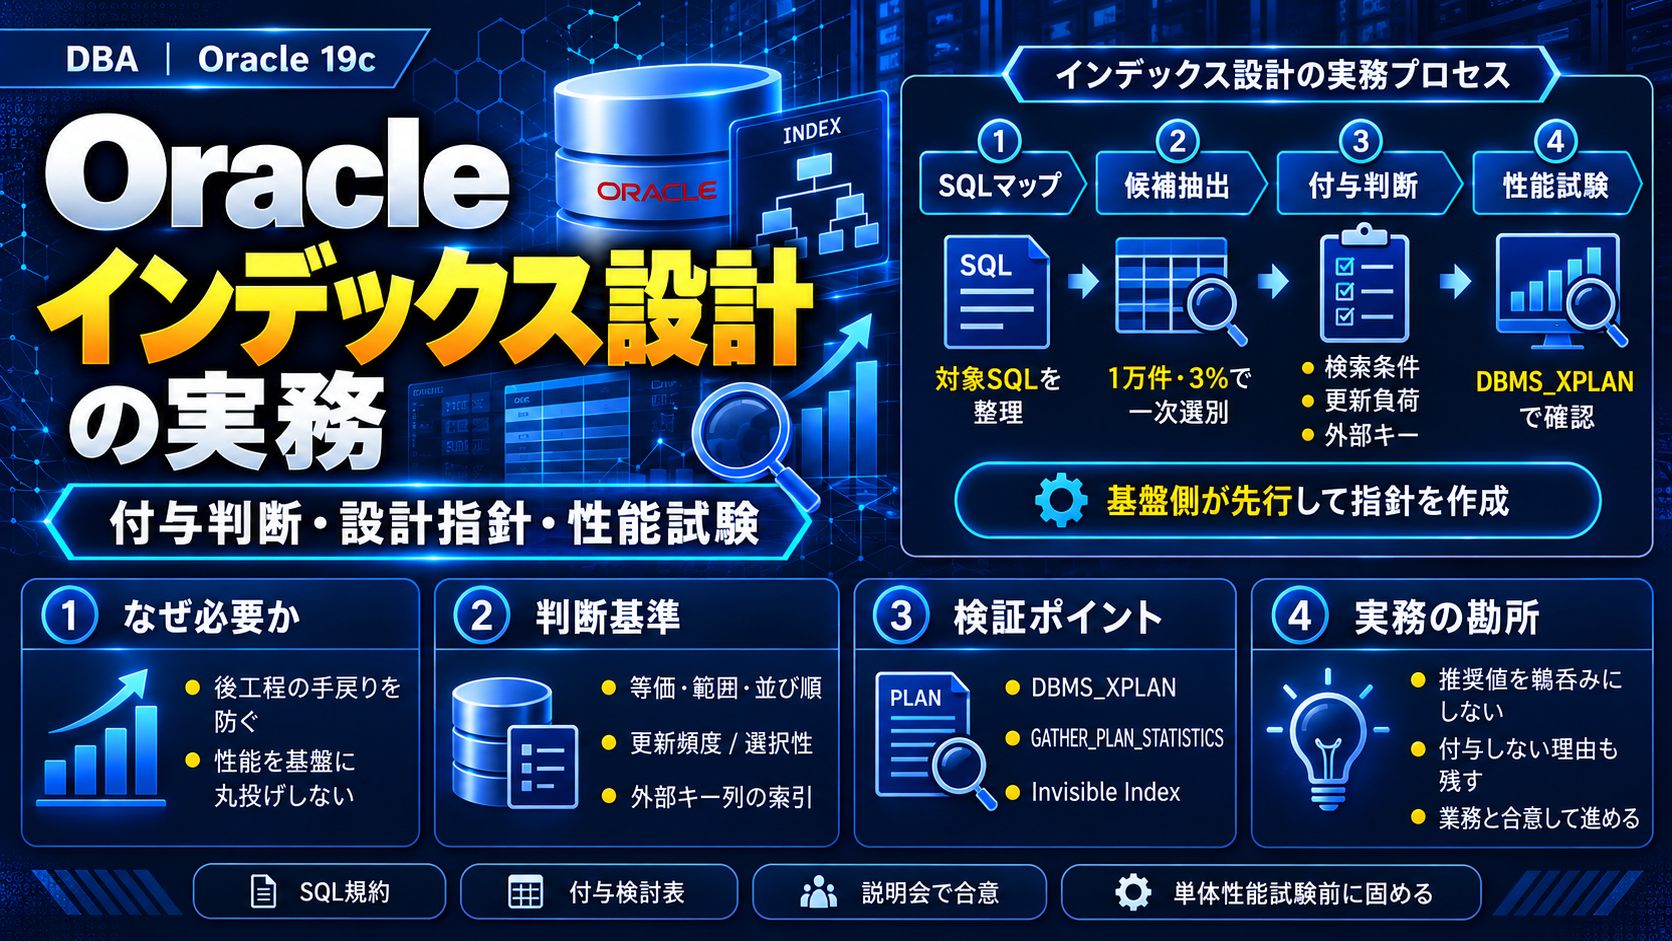
インデックスは、性能試験で遅いSQLが見つかってから追加すればよい。設計工程でそう割り切り、ほとんど検討しないまま単体性能試験を迎えるプロジェクトは少なくありません。大規模システムでこれをやると、膨大なSQLの中からボトルネックを探し、インデックスを設計し直す作業が試験工程に集中します。
とはいえ、SQLもデータ件数も固まっていない段階で、最適なインデックスを決めることはできません。必要なのは、設計段階で最低限の候補を抽出し、性能試験で効果を確かめながら見直す進め方です。
本記事では、業務側の設計がまだ本格的に動き出していない時期に、システム基盤側でインデックス設計を巻き取り、設計指針・実施要領・検討表を整えて業務チームへ展開した事例を紹介します。技術解説はOracle Database 19cを基準にしています。
事例中に登場する「1万件」「3%」などの各種数値は架空の値です。案件で作業量を絞るために置いた仮の一次選別ルールであり、Oracle 19cの推奨値や実測結果ではありません。
1. インデックス設計とは?「作る・作らない」を根拠付きで決める
インデックスがあれば速くなる、とは限らない
インデックスは、特定の検索条件に対して対象行を効率よく見つけるためのデータ構造です。Oracleで一般的なB-treeインデックスは、等価検索や範囲検索で有力なアクセスパスになります。
ただし、表の大部分を読むSQLでは、インデックス経由の行アクセスがかえって高コストになることがあります。インデックスはINSERT・UPDATE・DELETEのたびに維持されるので、増やすほど書き込み負荷と格納領域も増えます。
設計すべきなのは「どの列に索引を張るか」だけではありません。対象SQL、選択性、データ量、更新頻度、結合や並び替えの条件、既存索引との重複まで含めて、付与する理由と付与しない理由を説明できる状態にすることです。
| 検討項目 | 確認したいこと | 判断への影響 |
|---|---|---|
| SQLの使われ方 | WHERE、JOIN、ORDER BY、実行頻度 | 対象となる列と列順を考える |
| データ量 | 現在件数、試験時件数、将来の増加 | 全表走査と索引アクセスを比較する |
| 絞り込み | 想定ヒット件数、値の分布、偏り | 索引の選択性を見積もる |
| 更新特性 | 更新頻度、更新される列、バッチ量 | 追加索引の維持コストを評価する |
| 既存定義 | PK、ユニーク制約、既存索引 | 重複した索引を避ける |
| 外部キー | 子表の外部キー列、親表の削除・主キー更新 | 子表のロック競合を避ける |
| 業務要件 | 応答時間、夜間バッチの処理時間 | 検証の優先順位を付ける |
インデックス設計は物理設計とアプリケーション設計の接点
インデックスの判断には、DBAや基盤SEが持つDBの知識だけでなく、業務チームが把握しているSQL・検索条件・データ分布が必要です。設計書を一人で眺めて完結する作業ではありません。
データベース物理設計の全体像は、次の記事で紹介しています。インデックス設計は、その中でもSQLの処理特性に強く依存する領域です。
2. なぜ単体性能試験の前にインデックス設計が必要なのか
「性能は基盤がやるもの」という空気
このプロジェクトでは、設計が始まって間もない時期で、業務チームは画面や機能の設計に追われていました。インデックス設計どころではありません。加えて、性能は基盤の担当という空気がありました。
性能を基盤に預けたまま工程が進めば、そのツケは性能試験でまとめて返ってきます。単体性能試験では、ある程度のインデックスを付与した状態から性能を確認し、必要に応じて見直すのが現実的です。索引がほとんどない状態で大量のSQLを一斉に試験へ流せば、遅いSQLが多数出て、切り分けだけで工程が埋まります。
当時の設計指針にも、この考え方を明記していました。机上だけで正確に判断するのは難しい。ただ、インデックスをまったく作らずに試験すると、ボトルネックの特定が膨大になる。最低限のインデックス設計を先に行い、試験工程のSQLトレース等で見直す、という方針です。
押し付け合いになる作業を、先に巻き取る
担当が曖昧な作業は、どこのプロジェクトでも押し付け合いになり、誰も手を付けないまま期限を迎えます。インデックス設計はその典型です。
私はインデックス設計を基盤側で引き受けると宣言しました。作業を引き取るだけではなく、判断基準と進め方も基盤側で決める。その方針を示して、先行設計に着手しました。
開発プロセスを知らない人には、性能は基盤がやるものに見えていたようです。リーダークラスの中には、面倒な作業を基盤側が引き受けて助かった、と感じた人もいたように思います。私の見方は逆で、ここを握れば性能試験までの進め方を自分で組み立てられます。経験としても悪くないと考えました。
何を材料に先行したか
先行設計の材料は、SQLマップ、エンティティ定義書、想定レコード件数です。SQLは、プロトタイプアプリを作っていた業務チームと組んで集めました。完成したアプリケーションがなくても、主要な検索のパターンはプロトタイプの段階でかなり見えてきます。
ここで意識したのは、基盤側が業務の最終判断まで奪わないことです。私が作ろうとしたのは、業務側が後から検討を引き継げる共通の土台でした。
3. 設計指針はどう作るか――判断基準と成果物を基盤側で定義する
指針・実施要領・検討表・定義書を分ける
用意した成果物は、役割を明確に分けました。
| 成果物 | 役割 | 主に記録すること |
|---|---|---|
| インデックス設計指針 | 設計判断の原則をそろえる | 索引種別、件数・ヒット率の目安、付与時の注意点 |
| インデックス設計実施要領 | 作業手順をそろえる | SQL抽出、一次候補選別、定義書の作成方法 |
| インデックス付与検討表 | SQLごとの判断を残す | SQLマップ上の管理ID、参照表、除外理由、付与要否、見直し事項 |
| インデックス定義書 | 実装可能な形にする | 索引名、対象表、対象列・順序、索引種別、一意性、目的 |
| 付与分析資料 | 難しい候補を掘り下げる | 選択性、複合索引の列順、代替案と検証課題 |
この分け方の利点は、指針を変更したとき、どのSQLのどの判断に影響するかを追跡できることです。最終的なCREATE INDEX文だけを成果物にすると、「なぜ作ったのか」「なぜ作らなかったのか」が残りません。
ルールは一次選別用の仮基準として置く
指針には、候補を効率よく絞り込むための具体的な目安を入れました。
| 当時の仮基準 | 設計上の狙い | Oracle 19cでの位置づけ |
|---|---|---|
| 1万件未満の表は一次候補から除外 | 小規模表の検討負荷を減らす | 固定基準ではない。行長、ブロック数、アクセス頻度も確認 |
| 想定ヒット件数が表全体の3%以内 | 選択性の高い検索を優先 | 固定基準ではない。統計情報、Clustering Factor、実行計画で判断 |
| 非PK索引は原則5本以内 | DML負荷と管理負荷を抑える | 製品上限ではなく、案件内の設計抑制ルール |
| 複合索引の構成列は原則10列以内 | 索引の肥大化を抑える | 設計上の目安。必要な列と列順はSQL別に検証 |
| 複雑なJOIN・副問合せは「要注意」 | 机上判定が難しいSQLを明示 | 不要という意味ではなく、実行計画による検証対象 |
「1万件」「3%」「5本」「10列」は、Oracle製品の仕様上限でも、一般に正しい性能境界でもありません。限られた時間で検討の優先順位を付けるための基準です。Oracle 19cのオプティマイザは、統計情報、値の分布、I/Oコストなどからアクセスパスを選びます。しきい値だけで採否を確定させないことが前提です。
「例外」と「判断保留」の入口も決めておく
指針を機械的に適用すると、重要なSQLを見落とします。小さい表でも呼び出し回数が多ければ問題になり得ますし、JOINを含むSQLこそ性能の主要因になる場合があります。
実務で作る規約には、「原則」と同じくらい「例外の入口」が必要です。一次選別で除外したSQLも、不要と確定したのか、情報不足で判断保留なのか、実機試験へ回したのかを区別して残します。
4. SQLマップからインデックス付与候補を抽出する手順
手順1:SQLマップ上の管理IDと対象SQLを一覧化する
実施要領では、SQLマップの名前空間と、select・insert・update・deleteに相当するSQLの管理IDを抽出し、付与検討表に転記する手順を定めました。ここでの管理IDはアプリケーション設計資料上の識別子であり、OracleのV$SQL.SQL_IDとは別物です。
現在のプロジェクトなら、アプリケーションのSQL定義、ORMの生成SQL、SQL実行ログなども情報源になります。最初に押さえるべきは、SQLが「どの業務機能で使われるか」「どの表を参照・更新するか」を追跡できる状態にすることです。
手順2:一次候補を機械的に絞り込む
当時の実施要領では、次の順番でSQLを選別しました。
| 判定順 | 確認内容 | 当時の一次選別 | 現在の実務での扱い |
|---|---|---|---|
| 1 | SQL種別 | 動的SQL・単純INSERTは一次候補から外す | 動的SQLでも頻出条件があれば分析対象。INSERT…SELECTのSELECT側も確認 |
| 2 | JOIN・副問合せの有無 | 複雑なSQLは「要注意」として後工程へ | 重要SQLなら早期から実行計画を確認 |
| 3 | 主キーによる絞り込み | PKで十分なら追加不要候補 | PK索引で十分か、実行計画と取得行数で確認 |
| 4 | テーブル件数 | 1万件未満は一次候補から外す | 件数不明なら保留とし、追加調査へ |
| 5 | 想定ヒット件数 | 3%を超える場合は一次候補から外す | 選択性の仮評価。頻度・Clustering Factorも考慮 |
| 6 | 最終判断 | 残ったSQLを一次候補とする | SQLをまたいで索引統合・DML影響を検討 |
この方法の良いところは、すべてのSQLを同じ深さで分析しないことです。数の多いSQLから一次候補を機械的に選び、判断の難しいSQLと性能上重要なSQLへ検討工数を集中できます。
動的SQLやJOINを含むSQLでも、実行頻度が高いもの、業務上の応答時間が厳しいものは早い段階から実行計画を確認します。
手順3:選択性を仮計算する
想定100万行の表をCUSTOMER_IDで検索し、結果が500行と見積もられる場合、選択性は次のとおりです。
500行 ÷ 1,000,000行 × 100 = 0.05%
当時の基準なら一次候補に残ります。ここから「必ず索引を作る」とは決めません。値の偏り、索引から表へ戻るアクセスの回数、SQLの実行頻度、更新時の負荷、似た索引の有無を確認します。
逆に、100万行中20万行を取得する検索(20%)でも、索引だけで必要な列を取得できるケースや、複数条件の組み合わせで効果が出るケースがあります。数字は候補を絞るための入口で、最終判定ではありません。
手順4:複合インデックスの列順と、索引が使われない書き方を確認する
-- 説明用のSQL。実案件のSQLではありません。
SELECT ORDER_ID, ORDER_DATE, STATUS
FROM   ORDER_HEADER
WHERE  CUSTOMER_ID = :customer_id
AND    ORDER_DATE >= :date_from
AND    ORDER_DATE <  :date_to;
このSQLでは、CUSTOMER_IDの等価条件とORDER_DATEの範囲条件が候補になります。(CUSTOMER_ID, ORDER_DATE)の複合索引を比較対象にできますが、列順は他のSQLでの使われ方や値の分布も踏まえて決めます。
同じ表にCUSTOMER_ID単独、(CUSTOMER_ID, ORDER_DATE)、(CUSTOMER_ID, ORDER_DATE, STATUS)を無計画に重複作成しないことも大切です。Oracle 19cには先頭列を省略した場合のスキップ・スキャンもあるので、「先頭列がないと絶対に使われない」という古いルールをそのまま当てはめるのも適切ではありません。
索引を作っても、SQLの書き方で使われないケースもこの段階で拾っておきます。代表的なのは次の2つです。
- 列への関数適用:
WHERE TRUNC(ORDER_DATE) = :dのように列を関数で包むと、ORDER_DATEの通常の索引を使った効率的な範囲検索が難しくなります。日付の範囲条件に書き換えるか、関数ベース索引を検討します。 - 暗黙の型変換:VARCHAR2の列を数値のバインド変数と比較すると、列側にTO_NUMBERが適用され、索引が使われなくなります。SQL規約とバインド変数の型定義で防ぎます。
もう一つ、Oracleで見落とされやすいのが外部キー列の索引です。子表の外部キー列に索引がないと、親表の行削除や主キー更新の際に子表に表レベルのロック(TMロック)がかかり、子表への同時更新が待たされることがあります。検索条件に出てこない列でも、親表を削除・更新する処理があれば付与を検討します。
手順5:「不要」の理由まで記録する
インデックスを付与しない場合も、判断の根拠を残します。付与検討表の記入イメージは次のとおりです。
| SQL管理ID(例) | 機能 | 主な条件 | 一次判定 | 理由 | 次工程での確認 |
|---|---|---|---|---|---|
| SEL001 | 詳細照会 | ORDER_ID = :id | 追加不要候補 | PK等価検索で十分と想定 | 想定行数と実行計画 |
| SEL002 | 一覧照会 | CUSTOMER_ID = :id | 付与候補 | 大量表を少数行に絞り込む | 索引有無の応答時間・I/O比較 |
| SEL003 | 複合検索 | JOIN+期間条件 | 判断保留 | JOIN順序と対象件数が未確定 | データ整備後の実行計画 |
| UPD001 | 状態更新 | ORDER_ID = :id | 追加不要候補 | PK利用。索引追加による更新負荷も懸念 | 同時更新・バッチ時間 |
※この表の管理ID・表名・SQL条件は説明用の例です。
5. 実務事例:先行設計で「作らない」判断も残す
業務領域ごとに付与判断が分かれた
業務グループが本格的に設計へ取りかかる前に、私は開発が先行する業務領域について、基盤側でインデックスを設計しました。結果は次のとおりです。
| 業務領域 | 先行設計での判断 | ポイント |
|---|---|---|
| 業務A | 3テーブルにインデックスを付与 | 中間一致・後方一致検索への対応を含め、業務側に引き継ぎ |
| 業務B | 8テーブルにインデックスを付与 | カーディナリティの想定が変われば再検討を依頼 |
| 業務C | 付与なし | 対象テーブルの想定件数がいずれも1万件未満で、一次候補条件に該当しなかった |
「3」「8」はインデックスの本数ではなく、インデックスを付与したテーブルの数です。業務Cでは当時の一次選別基準に該当する表がなく、後工程の再評価対象として判断を記録しました。
すべての業務領域に同じように索引を作るのではなく、候補を抽出し、作らない場合も理由を残して後から見直せるようにする。先行設計で狙ったのはそこです。
中間一致・後方一致は、通常の選別とは切り分けた
業務Aには、中間一致・後方一致検索の性能課題がありました。通常のB-tree索引は LIKE 'ABC%' のような前方一致には有効な場合がありますが、LIKE '%ABC' や LIKE '%ABC%' では、範囲スキャンで効率よく絞り込めません。
なお、LIKE検索では、インデックスの利用可否だけでなく、検索条件の解釈にも注意が必要です。
過去に私が担当したプロジェクトでは、Oracleの不具合により、全角アンダースコア「_」がワイルドカードとして扱われ、想定外の大量ヒットが発生しました。
実機検証による原因調査から、LIKECの検証、SQL改修・運用回避の判断、再発防止までの経緯は、次の記事で解説しています。
この検索は一次選別の流れには乗せず、中間一致・後方一致に対応する索引を個別に設計し、定義書と分析資料に設計理由を残して業務側へ引き継ぎました。現在の案件で同じ要件が出た場合は、Oracle Textなどの適用可否も含め、検索要件、運用負担、ライセンス条件を合わせて評価します。
設計に使った資料の「時点」を残して引き継ぐ
先行設計で気をつけたのは、使った情報が必ずしも最新ではないことです。SQLマップ、エンティティ定義書、想定レコード件数は、それぞれ異なる時点の資料でした。列のカーディナリティも、一部は想定を置いて判断しています。
業務グループへの引き継ぎでは、設計に使った各資料の時点と前提条件を明記し、最新資料との差異やカーディナリティの見込み違いがあれば再評価するよう依頼しました。基盤側で設計を先行させることと、業務側の検証を省略することは別の話です。
入力となる件数やSQLが変われば、同じ判断表でも結論は変わります。使用した資料の版と判断日を残すことは、インデックス名を決めることと同じくらい重要です。
6. 業務グループへ展開する――説明会・修正・引き継ぎ
説明会で手順をそろえる
一部の業務領域を基盤側で先行設計できても、プロジェクト全体のSQLを基盤チームが把握し続けるのは現実的ではありません。SQLの機能要件や業務データの分布を一番よく知っているのは、各業務グループです。
そこで、業務GLとインデックス設計担当者を集めて説明会を開き、設計指針、実施要領、付与検討表、定義書の作り方を一通り説明しました。インデックスの一般的な仕組みではなく、SQLマップのどこを見て、どの条件で候補を絞り、検討表や定義書に何を記録するのか。基盤側の先行設計を実例として見せ、業務グループでも同じ手順を踏めるようにしました。
たたき台を出すと、指摘が出てくる
説明会では、作成した指針や検討結果について指摘が出ました。自分たちではなかなか手を付けないのに、たたき台には意見が出る。正直に言えば、カチンときたのも事実です。
ただ、指摘を受けてあるSQLの判定を「必要」から「不要」に改め、実施要領にも作業手順の説明を追記しています。白紙の段階では出てこなかった業務側の知見が、たたき台を出したことで初めて表に出てきたわけです。最終的に同じ基準で合意できたので、結果としては良かったと思っています。
指摘を反映した版を共通の設計資料として配布し、業務側の検討へ引き継ぎました。
誰が何を更新するかまで決める
引き継ぎでは、役割も整理しました。基盤・DBAは指針と技術上の制約、共通レビュー、実行計画の技術支援を持つ。業務・アプリケーション担当は、SQLとデータ件数の更新、候補抽出、定義書の作成を持つ。性能試験担当は、試験条件と実績値、SQLトレースや実行計画の取得を持つ。GLは役割分担と改訂ルールの周知、判断保留の解消を持つ。
肩書きはプロジェクトによって変わります。決めておくべきなのは、設計の根拠となった情報が更新されたとき、誰が再判定するかです。
7. Oracle 19cでは、設計したインデックスをどう検証するか
机上見積と実機の結果を分けて見る
インデックスの最終的な有効性は、実行計画と実行統計で確認します。見る対象は検索時間だけではありません。
| 検証観点 | 具体的に見るもの |
|---|---|
| 選択性 | 想定行数と実際の取得行数、値の偏り |
| アクセスパス | INDEX RANGE SCAN、TABLE ACCESS FULLなど |
| 実行統計 | 経過時間、Buffers、Reads、実行回数 |
| 推定精度 | E-RowsとA-Rowsの乖離 |
| 索引の構造 | DISTINCT_KEYS、CLUSTERING_FACTORなど |
| 更新性能 | INSERT/UPDATE/DELETEやバッチ処理への影響 |
| 再現性 | 統計情報、テストデータ、SQL、バインド条件の一致 |
データ量、統計情報、バインド変数、SQLの条件をそろえ、索引がある場合とない場合を比較します。差が出ても索引だけが原因とは限らないので、実行計画の変化を必ず確認します。
DBMS_XPLANで実行計画と実績値を見る
Oracle 19cでは、DBMS_XPLAN.DISPLAY_CURSORで実際に実行したSQLの計画を確認できます。行数やBuffersの実績値を取るには、対象SQLにGATHER_PLAN_STATISTICSヒントを付けるのが影響範囲が狭く扱いやすい方法です。セッション全体で statistics_level = ALL にする方法もありますが、そのセッションのすべてのSQLに計測負荷がかかります。
-- 説明用の手順例。実案件の実測結果ではありません。検証環境で実行してください。
SELECT /*+ GATHER_PLAN_STATISTICS */
       ORDER_ID, ORDER_DATE, STATUS
FROM   ORDER_HEADER
WHERE  CUSTOMER_ID = :customer_id
AND    ORDER_DATE >= :date_from
AND    ORDER_DATE <  :date_to;

SELECT *
FROM   TABLE(DBMS_XPLAN.DISPLAY_CURSOR(
         sql_id          => :target_sql_id,
         cursor_child_no => NULL,
         format          => 'ALLSTATS LAST'));
DBMS_XPLANの参照には、動的パフォーマンスビューへのアクセス権限が必要です。検索1回だけで判断せず、代表的なバインド値、データ量、実行頻度で確認します。
統計情報とカーディナリティを確認する
インデックスを作っても、オプティマイザが使うとは限りません。特定の値にアクセスが集中する列では、平均的な選択性と実態が一致しないことがあります。
SELECT table_name, num_rows, blocks, last_analyzed
FROM   user_tables
WHERE  table_name = 'ORDER_HEADER';

SELECT index_name, blevel, leaf_blocks,
       distinct_keys, clustering_factor, last_analyzed
FROM   user_indexes
WHERE  table_name = 'ORDER_HEADER';
統計情報が古い場合は、検証条件を整えたうえでDBMS_STATSによる収集を検討します。収集前後で実行計画が変わる可能性があるので、性能検証の途中で無計画に統計情報を更新しないようにします。
Invisible IndexとAutomatic Indexingの使いどころ
Oracle 19cのInvisible Indexは、索引をオプティマイザから見えなくする機能です。検証用セッションで ALTER SESSION SET OPTIMIZER_USE_INVISIBLE_INDEXES = TRUE; とすれば、他のセッションに影響を与えずに、その索引がある場合の実行計画を確認できます。ただし、Invisible IndexもDMLのたびに維持されます。参照側の比較には使えますが、更新負荷の検証は別に必要です。
自動インデックス作成機能(Automatic Indexing)は、Oracle 19cの通常のEnterprise Edition(EE)だけでは利用できません。OracleのLicensing Informationでは、Exadata上のEnterprise Edition on Engineered Systems(EE-ES)や対象のExadata Database Serviceで利用可能とされています。Autonomous Databaseでも提供されています。導入を検討する際は、製品・サービスと契約上の利用条件を確認します。
特定の機能を使うことがゴールではありません。設計時の仮説を計測で更新し、その理由を記録することがゴールです。
8. まとめ:インデックス設計は「試験前に仮説を作る仕事」
インデックス設計は、すべてのSQLを完成させ、十分な試験データを揃えてから始める作業ではありません。大規模開発では、業務チームの設計進捗や資料の不足に関係なく、単体性能試験の準備期限が来ます。
今回の事例では、基盤側でSQLマップ・エンティティ定義・想定件数から一次候補を抽出し、設計指針、実施要領、付与検討表、インデックス定義書を用意しました。先行設計の結果は、資料の時点と前提を明記して業務チームへ引き継ぎ、説明会での指摘を受けて判定と手順を直しています。最終的な有効性は、Oracle 19cの実行計画と実績値で確かめる前提です。
所感
振り返ると、一番の収穫は、試験に入る時点で「なぜこの索引があり、なぜこの表にはないのか」を説明できる状態を作れたことです。単体性能試験で遅いSQLが出ても、付与検討表を見れば、当時の前提と判断理由に戻れます。前提が変わっていれば判断を更新し、変わっていなければ実行計画を見て原因を絞り込む。手戻りをゼロにはできなくても、手戻りの範囲は小さくできます。
指針も最初から完成していたわけではなく、説明会の指摘を受けて判定と手順を直しました。完璧な規約を目指して止まるより、たたき台を出して業務側の知見を取り込み、同じ版を全員で使う。大規模開発のインデックス設計は、この進め方が現実的だと考えています。
参考資料(Oracle公式)
- Oracle Database 19c SQL Tuning Guide
- Query Optimizer Concepts:選択性・カーディナリティ
- Optimizer Statistics Concepts:Clustering Factorなど
- DBMS_XPLAN:DISPLAY_CURSOR
- Managing Indexes:Invisible Indexなど
- Database Licensing Information:Automatic Indexingの利用条件
関連記事
この記事の裏側をnoteに書きました
「性能は基盤でしょ」という空気の中で、押し付け合いになっていたインデックス設計をなぜ引き受けたのか。その経緯と立ち回りは、noteの体験記にまとめています。
コメント